Teknik not
Yapay Zekâ Eğitim Verisindeki Etiket Hataları Nasıl Bulunur?
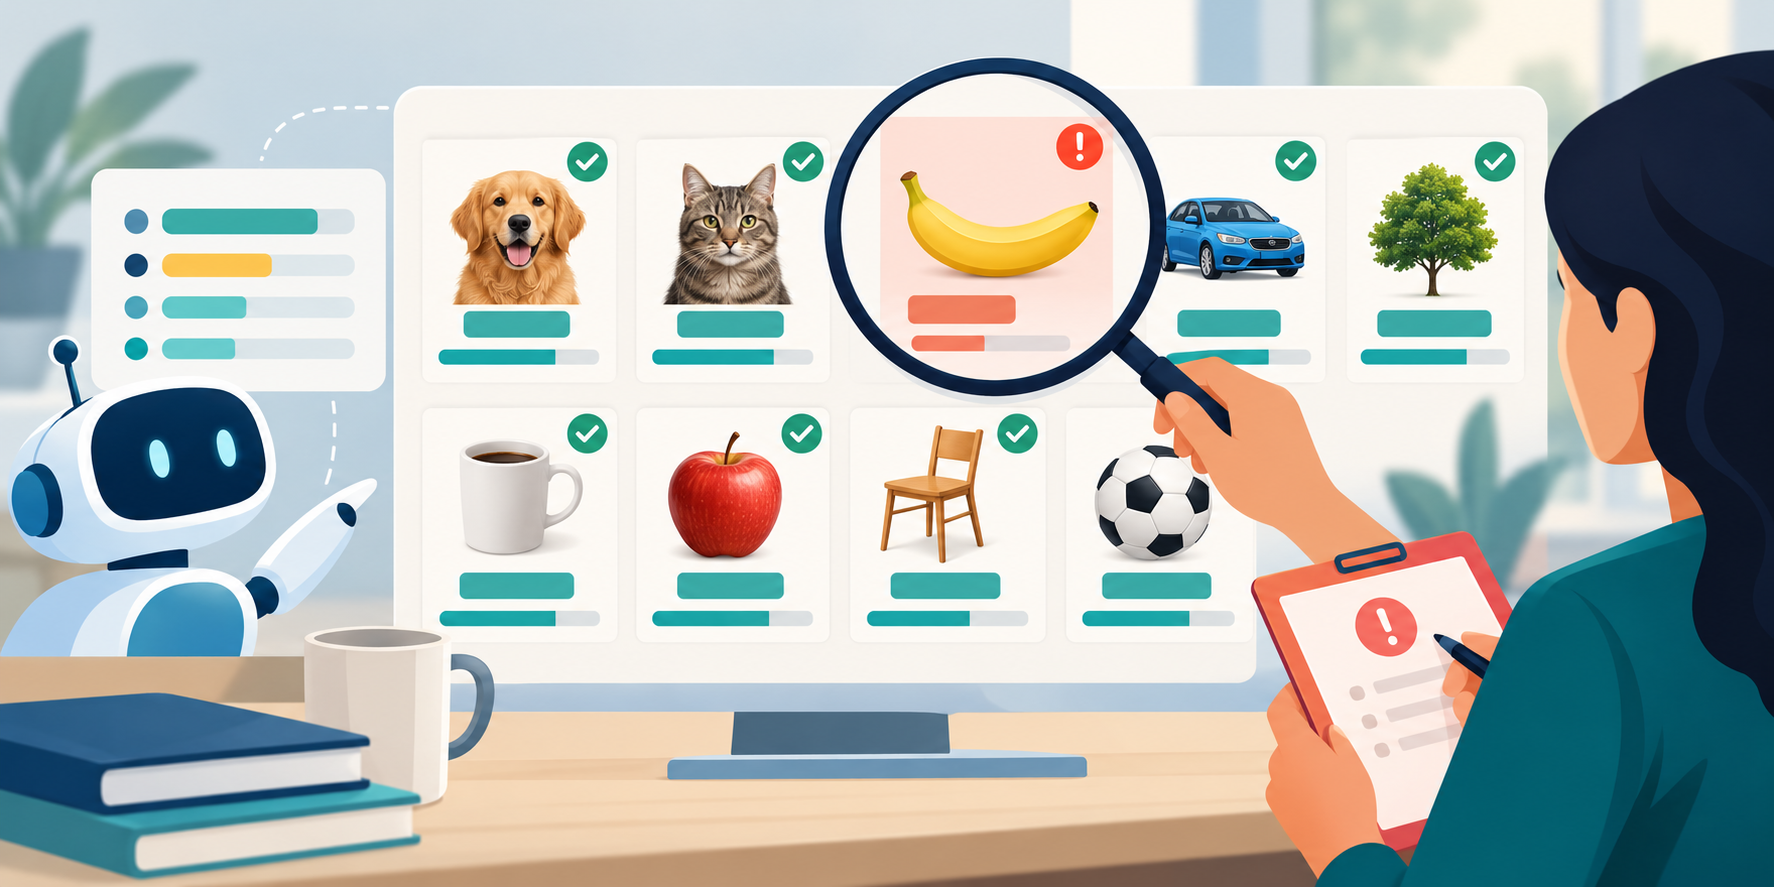
Fotoğrafta köpek var, ama veri tablosundaki etiketi “kedi”. Model bu örneği yanlış öğrendiğinde, sorun her zaman algoritmada değildir; eğitim verisindeki etiket hatası da olabilir. Bu tür hatalar, modelin başarısını düşürür ve gerçek nedeni bulmayı zorlaştırır.
Bu rehberde etiket hatası tespiti yaklaşımını, modelin her örnek için ürettiği olasılıklardan yararlanarak anlatıyorum. Örnekleri otomatik düzeltmek yerine, şüpheli kayıtları doğru biçimde inceleyip insan onayıyla düzeltmeyi öğreneceksiniz.
Etiket hatası nedir?
Etiket, modele bir örneğin ne anlama geldiğini söyleyen cevaptır. Bir e-posta “spam” veya “normal”, bir yorum “olumlu” veya “olumsuz”, bir fotoğraf “köpek” veya “kedi” olarak etiketlenebilir.
Bir çalışan etiketi yanlış seçmiş olabilir. İki değerlendirici de farklı karar verebilir. Bazen dosya ile etiket eşleşmesi kayar. Model bu yanlış örneği de gerçekmiş gibi öğrenir. Çok sayıda hatalı ya da belirsiz kayıt, test başarısını ve özellikle az görülen sınıfları olumsuz etkileyebilir.
Model, yanlış etiketi nasıl fark etmeye yardım eder?
Bir sınıflandırma modeli yalnızca “kedi” gibi tek bir cevap vermek yerine, her sınıf için olasılık da üretir. Örneğin model bir fotoğraf için köpeğe %92, kediye %6 olasılık veriyor; kayıt etiketi ise “kedi” diyorsa bu örnek incelemeye değer olabilir.
Confident Learning, gözlenen etiketlerle modelin her örnek için ürettiği olasılıkları karşılaştırır. Ardından, etiket sorunu olma ihtimali yüksek kayıtları sıralar. Cleanlab gibi araçlar bu işi uygulamayı kolaylaştırır. Bu sıralama “etiket kesin yanlış” anlamına gelmez: örnek gerçekten zor, birden fazla yoruma açık veya modelin görmediği bir türde olabilir.
Adım adım etiket hatası tespiti
1. Veriyi ve etiketleri düzenleyin
Her kayıt için değişmeyen bir kimlik, özellikler ve mevcut etiketi saklayın. Örneğin id, metin ve etiket sütunları kullanabilirsiniz. Özgün dosyayı saklayın. Böylece hangi kaydı değiştirdiğinizi takip edebilirsiniz.
2. Temel bir sınıflandırıcı seçin
Önce işinize uygun, basit bir model kurun. Metin için TF-IDF ve lojistik regresyon, tablo verisi için bir ağaç tabanlı sınıflandırıcı başlangıç olabilir. Buradaki amaç en iyi modeli bulmak değil; her sınıf için makul olasılıklar üretmektir.
3. Her örneğin model tarafından görülmemiş tahminini üretin
Model bir örneği eğitimde gördüyse o örneği ezberlemiş olabilir. Bu yüzden katlamalı çapraz doğrulama kullanın. Her katmanda, bazı kayıtları modelden saklayın. Ardından modeli kalan kayıtlarla eğitin ve sakladığınız örnekleri tahmin ettirin. Böylece model, puanladığı örneği eğitimde görmemiş olur.
from sklearn.model_selection import StratifiedKFold, cross_val_predict
from cleanlab.filter import find_label_issues

# model: predict_proba destekleyen bir sınıflandırıcı veya Pipeline
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
pred_probs = cross_val_predict(
    model, X, y, cv=cv, method="predict_proba"
)

issue_indices = find_label_issues(
    labels=y,
    pred_probs=pred_probs,
    return_indices_ranked_by="self_confidence",
)

# İlk sıradaki kayıtları kimlikleriyle inceleyin
for idx in issue_indices[:20]:
    print(record_ids[idx], y[idx], pred_probs[idx])
X özellikleri, y ise sayısal sınıf etiketlerini temsil eder. Ön işleme adımlarını da çapraz doğrulamanın içinde çalıştırmak için modeli bir scikit-learn Pipeline olarak kurun. Olasılık sütunlarının sınıf sırasının etiket kodlarınızla aynı olduğunu kontrol edin. Kod, şüpheli kayıtların indekslerini verir; veriyi kendi başına düzeltmez.
4. Şüpheli kayıtları insan gözüyle doğrulayın
İlk 20 veya 50 adayı açıp özgün metin, görsel ve etiketleme kuralıyla karşılaştırın. Kaydı “yanlış etiket”, “belirsiz örnek” ya da “modelin zorlandığı doğru örnek” olarak ayırın. Belirsiz kayıtlarda ikinci bir değerlendiriciden destek alın veya açık bir karar kuralı yazın.
5. Düzeltmeleri kaydedin ve yeniden ölçün
Değişikliği kimin yaptığını, ne zaman yaptığını ve hangi kanıta dayandığını kaydedin. Sonra modeli aynı yöntemle yeniden değerlendirin. Sonuçları eğitimde kullanmadığınız ayrı bir test kümesinde ölçün. Mümkünse bu kümedeki etiketleri bir kişi de kontrol etsin.
Sonuçları yorumlarken dikkat edin
- Modelin tahmini hakikat değildir. Hata bulucu, inceleme kuyruğu hazırlar; nihai kararı insan verir.
- Azınlık sınıflarını ayrıca kontrol edin. Dengesiz veri küçük sınıfları az örnekle temsil eder. Bu yüzden aday sayılarını her sınıf için ayrı inceleyin.
- Etiket yönergesini netleştirin. İnsanların aynı örneğe farklı etiket verdiği durumlar, yalnızca yazım hatası olmayabilir. Örnekli bir etiketleme kılavuzu hazırlayın.
- Test verisini eğitimden ayrı tutun. Sonuçları iyileştirmek için test kayıtlarını tekrar tekrar kullanmayın.
Kısa özet
Etiket hatası tespiti, model olasılıklarını kullanarak eğitim verisindeki şüpheli kayıtları bulup incelemeyi sağlar. Güvenilir bir akış için modelin görmediği tahminleri çapraz doğrulamayla üretin, Cleanlab ile adayları sıralayın ve her düzeltmeyi insan onayıyla kaydedin. Böylece modelin başarısızlığını yalnızca algoritmada aramak yerine, eğitim verisinin kalitesini de ölçebilirsiniz.