Teknik not
Tokenizer Nedir? Türkçe Metinler Neden Daha Fazla Token Tüketebilir?
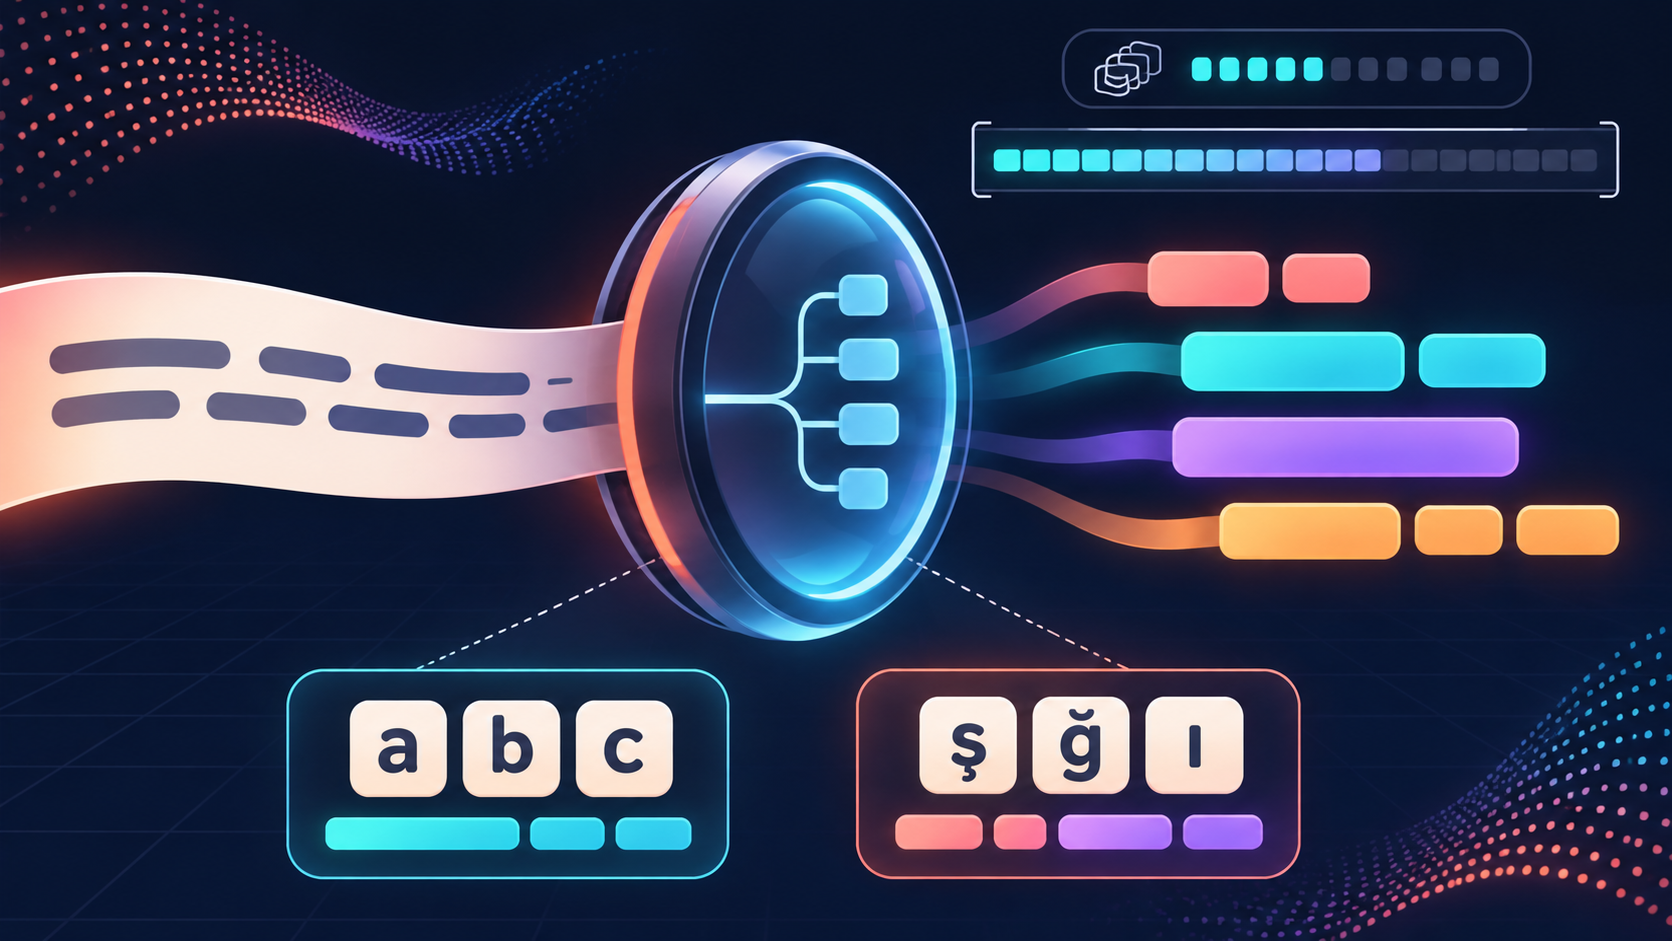
Bir metindeki kelime sayısı, yapay zekâ modelinin gördüğü uzunluğu tek başına anlatmaz. Model metni token adı verilen parçalara ayırır; bir token bazen tam bir kelime, bazen ek, noktalama işareti ya da kelimenin yalnızca bir bölümü olabilir. Bu yüzden Türkçe bir istemin token sayısını tahmin etmek yerine kullandığınız modelin tokenizer’ıyla ölçmek daha güvenilirdir.
Tokenizer ne yapar?
Tokenizer, yazıyı modelin işleyebileceği bir token kimlikleri dizisine dönüştürür. Yaygın bir yöntem olan byte-pair encoding (BPE), metni küçük parçalara ayırır ve sık birlikte görülen parçaları daha büyük birimler olarak kullanır. Böylece sık rastlanan bir kelime tek token olabilirken, daha az görülen bir kelime birkaç parçaya ayrılabilir. Tokenlaştırma modele ve kullandığı sözlüğe bağlıdır; bütün modeller aynı metni aynı şekilde bölmez.
OpenAI’nin Tokenizer aracı, seçilen kodlayıcıya göre parçalanmayı görselleştirir. Token bir kelimeyle bire bir eşleşmediği için “100 kelime yaklaşık şu kadar token eder” gibi kestirmeler yalnızca kaba planlamada işe yarar. Özellikle Türkçe, özel adlar, birleşik kelimeler, emoji ve kod içeren metinlerde gerçek sayıyı ölçmek gerekir.
Türkçe metinler neden farklı sayılabilir?
Türkçede kelimelere ekler art arda gelebilir; ayrıca ı, İ, ş, ğ gibi karakterler ve noktalama da kodlayıcının öğrendiği parça sıklıklarını etkiler. Bu, her Türkçe metnin İngilizceden daha fazla token kullanacağı anlamına gelmez. Sonuç; kelime seçimine, yazım biçimine ve kullanılan tokenizer’a göre değişir. Aynı cümlenin boşlukları veya noktalaması değiştiğinde bile parçalanma farklılaşabilir.
Token sayısını kendi metninizde ölçün
OpenAI modelleri için açık kaynaklı tiktoken kitaplığı, metni uygun kodlayıcıyla saymanıza yardımcı olur. Aşağıdaki örnek GPT-4o ile ilişkili kodlayıcıyı seçer; başka bir model kullanıyorsanız o modelin kodlayıcısını kullanın:
import tiktoken

encoding = tiktoken.encoding_for_model("gpt-4o")
text = "Yarın toplantı notlarını özetle."
tokens = encoding.encode(text)

print("Token sayısı:", len(tokens))
print("Token kimlikleri:", tokens)
Parçaların metin olarak nasıl göründüğünü incelemek için aynı cümleyi OpenAI Tokenizer aracına yapıştırın. Kodlayıcı değişince sonuç da değişebilir; bir model için aldığınız sayıyı başka bir modele otomatik olarak taşımayın.
Maliyet ve bağlam planlamasında nelere bakmalı?
- Tek bir kullanıcı mesajını değil, modele gönderdiğiniz sistem talimatlarını ve korunacak sohbet geçmişini de hesaba katın.
- Görsel, ses veya araç tanımları içeren isteklerde yalnızca görünen metni saymak yeterli olmayabilir.
- Uzun yanıt üretilmesini bekliyorsanız çıktı için de bağlam ve bütçe payı bırakın.
- Fiyatlandırma modele ve API’ye göre değişebileceğinden, token sayısını doğrudan sabit bir para tutarı gibi yorumlamayın.
Üretimde en sağlam kontrol, API yanıtındaki kullanım bilgilerini kaydetmektir. Böylece tahmin ettiğiniz giriş ve çıkış tokenlarını gerçek isteklerle karşılaştırabilir, Türkçe istemleriniz için ortalama ve yüksek kullanım örneklerini görebilirsiniz.
Kısa uygulama planı
- İsteklerinizi hangi modelin işleyeceğini belirleyin.
- Geliştirme aşamasında o modelle uyumlu tokenizer kullanarak Türkçe örneklerinizi sayın.
- Prompt şablonunu, konuşma geçmişini ve varsa araç tanımlarını da ölçüme katın.
- Canlı API kullanımını kaydedip tahminlerinizi gerçek sonuçlarla güncelleyin.
Tokenizer’ı anlamak, her kelimenin kaç token tuttuğunu ezberlemek demek değildir. Amaç, gerçek metni doğru modelin kodlayıcısıyla ölçmek ve kullanım verisiyle tahmini doğrulamaktır. Bu küçük kontrol, bağlam penceresini planlamayı ve token bazlı maliyetleri daha öngörülebilir hâle getirir.