Teknik not
Speculative Decoding Nedir? Yapay Zekâ Yanıtları Nasıl Hızlandırılır?
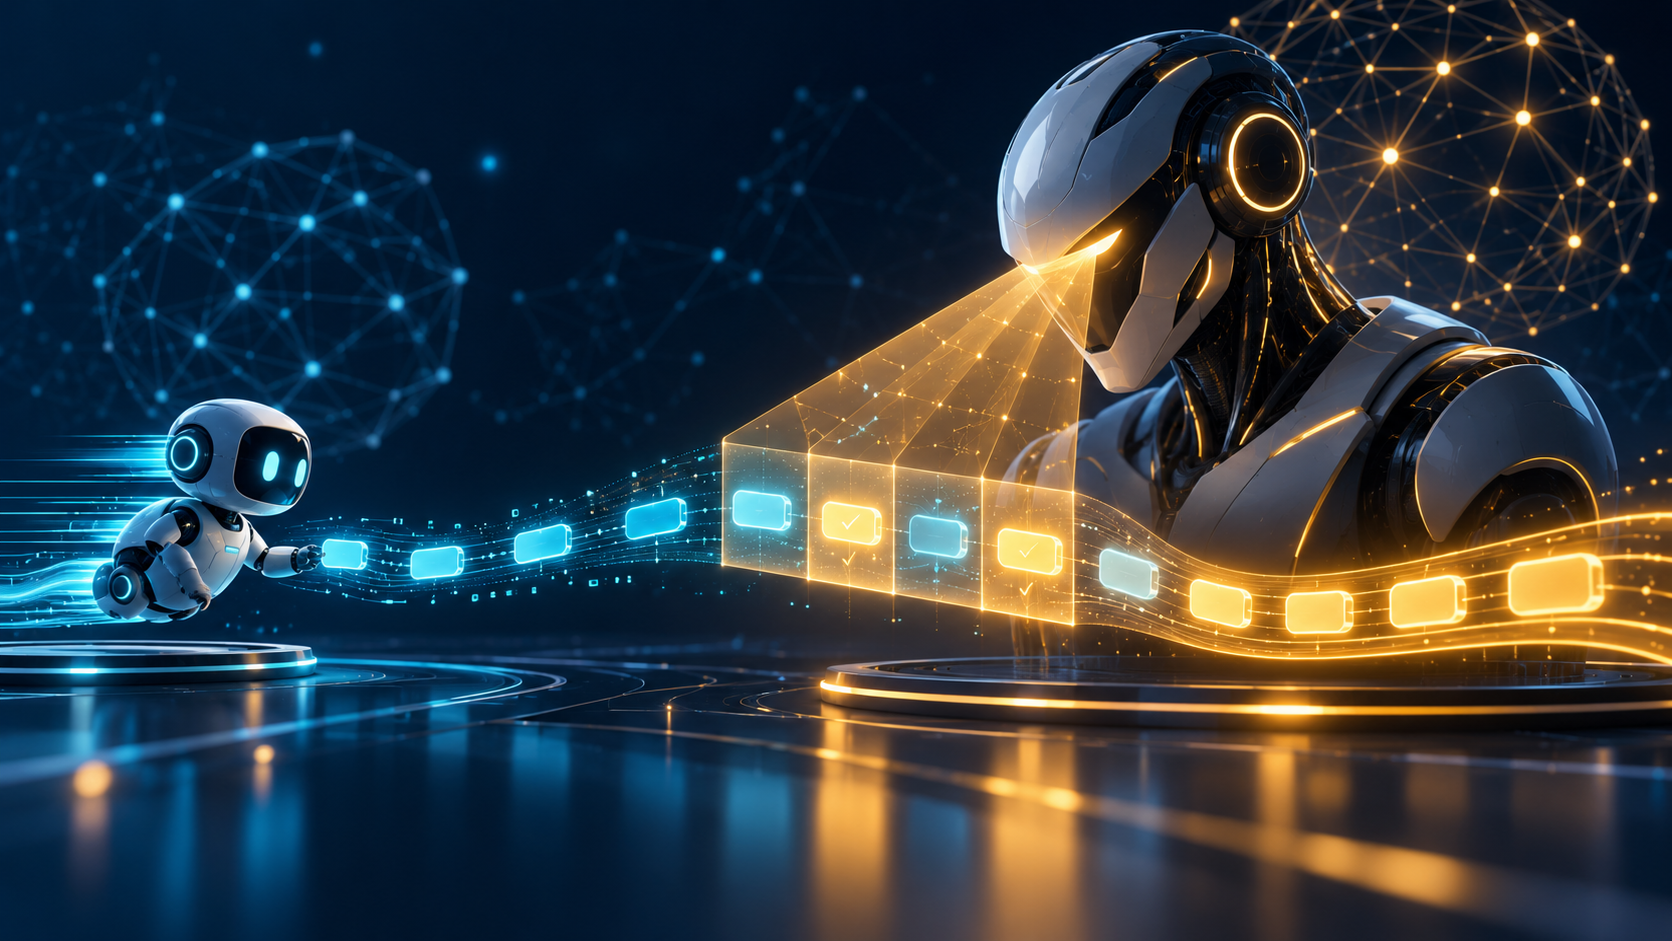
Speculative decoding, büyük dil modellerinin yanıt üretimini hızlandırmak için kullanılan akıllı bir yöntemdir. Küçük ve hızlı bir model birkaç kelimelik taslak hazırlar; güçlü model bu taslağı kontrol eder. Böylece güçlü modelin her kelimeyi tek tek beklemesi gerekmez.
Speculative decoding nedir?
Bir dil modeli yanıtı genellikle token adı verilen küçük parçalardan sırayla üretir. Her yeni parça, öncekinin devamına bağlıdır. Büyük bir modelde bu ardışık işlem yanıtı yavaşlatabilir.
Speculative decoding bu beklemeyi azaltır: Küçük bir “taslak model” olası devamı önerir, asıl büyük model ise önerileri topluca doğrular. Yöntem, bilgisayarlardaki tahmine dayalı çalışmaya benzer: Önce olası işler hazırlanır, sonra gerçekten kullanılacak olanlar kontrol edilir.
Nasıl çalışır? Dört basit adım
- Taslak oluşturulur: Küçük model, ana modelin yanıtında sırada gelebilecek birkaç token önerir.
- Ana model kontrol eder: Büyük model, taslağın devamını tek seferde değerlendirir. Bu kontrol, tokenları birer birer üretmekten daha paralel ilerleyebilir.
- Uyan bölüm kabul edilir: Ana modelin olasılıklarıyla uyumlu taslak parçaları korunur.
- Gerekirse düzeltilir: Taslak bir noktada uyuşmazsa ana model o noktadan doğru örneklemeyi sürdürür; ardından yeni bir taslak turu başlar.
Bu nedenle küçük modelin yazdığı her şey otomatik olarak son yanıta eklenmez. Taslak, büyük modelin denetiminden geçer.
Kısa bir örnek
Bir asistana “Yağmur başladığında dışarı çıkarken…” diye sorulduğunu düşünün. Küçük model “şemsiye al” gibi muhtemel bir devamı ve birkaç sonraki tokenı taslak olarak üretir. Büyük model bunların her birini sırayla ayrı çağrılarla üretmek yerine birlikte kontrol eder. İlk parçalar uygunsa onları kabul eder; devamın bir bölümü uymuyorsa oradan itibaren kendi dağılımına göre düzeltir.
Kaliteden ödün vermeden hızlandırır mı?
Özgün yöntemin önemli yanı, doğru örnekleme kuralıyla ana modelin çıktı olasılık dağılımını değiştirmeden daha hızlı üretim hedeflemesidir. Bu, her çalıştırmada kelimesi kelimesine aynı yanıtın çıkacağı anlamına gelmez; anlamı, yöntem yüzünden yanıtların olasılıklarının teorik olarak farklı bir dağılıma kaymamasıdır.
Leviathan, Kalman ve Matias’ın 2023 tarihli çalışması, T5-XXL için kendi test ortamlarında standart T5X uygulamasına kıyasla yaklaşık 2–3 kat hızlanma bildirdi. Bu sayı her model, ekran kartı veya sunucu için garanti değildir; sonuç kullanılan taslak modele ve donanıma bağlıdır.
Neden her zaman hız kazandırmaz?
Taslak model ana modelin devamını sık tahmin edebiliyorsa daha çok token tek kontrolde kabul edilir ve yöntem işe yarar. Taslaklar çoğu kez reddediliyorsa ek modelin ürettiği öneriler boşa gider. Ayrıca ana modelin toplu doğrulama maliyeti, sistemin bellek aktarımı ve aynı anda çalışan istek sayısı sonucu etkiler.
Kısacası hızlanma; “küçük model var, öyleyse yanıt kesin hızlanır” demek değildir. Gerçek iş yükünde ölçmek gerekir.
Bir uygulamada nasıl test edilir?
- Kullandığınız model sunucusunun speculative decoding özelliğini destekleyip desteklemediğini kontrol edin.
- Aynı model, istemler, donanım ve eşzamanlı istek sayısıyla önce normal üretimi ölçün.
- Uygun bir taslak model ve kısa bir taslak uzunluğuyla yöntemi deneyin.
- Yeterli sayıda gerçekçi istemde token/saniye, tokenlar arası gecikme ve yüzde 95 gecikmesini karşılaştırın.
- Hızın yanında çıktı kalitesini, hata oranını ve toplam kaynak maliyetini de izleyin. Kazanç yoksa normal üretime dönün.
Özet
Speculative decoding, küçük modelin hazırladığı taslağı büyük modele doğrulatarak dil modeli üretimindeki ardışık beklemeyi azaltır. Doğru koşullarda kalite dağılımını korurken hız kazandırabilir; ancak hız artışı garanti değildir. En sağlıklı karar, kendi modeliniz ve gerçek isteklerinizle ölçüm yapmaktır.
Kaynak
Leviathan, Kalman ve Matias, “Fast Inference from Transformers via Speculative Decoding”, ICML 2023.