Teknik not
Precision ve Recall Nedir? Yapay Zekâ Başarısını Ölçmek
Bir yapay zekâ modeli yüzde 99 doğrulukla çalışıyor. Harika görünüyor, değil mi? Ama modelin yakalaması gereken tüm spam e-postaları kaçırdığını düşünün. Böyle bir sonuç mümkün. Precision ve recall, başarı yüzdesinin arkasındaki bu farkı görmenizi sağlar.
Bu rehberde iki kavramı bir spam filtresi üzerinden öğrenecek, sonuçları kendiniz hesaplayacak ve modeliniz için hangi ölçütün daha önemli olduğuna karar vereceksiniz. Kod bilgisine ihtiyacınız yok.
Yüzde 99 doğruluk neden yanıltıcı olabilir?
Elimizde 1.000 e-posta olsun: 990 tanesi normal, 10 tanesi spam. Her e-postaya “normal” diyen bir sistem, 990 doğru tahmin yapar. Doğruluk oranı, yani accuracy, yüzde 99 çıkar. Buna rağmen sistem tek bir spam bile yakalayamaz.
Normal e-postaların sayısı çok daha fazla olduğu için genel yüzde, spam tarafındaki başarısızlığı gizler. Bu örnek, sınıfların sayısı birbirinden çok farklı olduğunda neden yalnızca doğruluğa bakmamak gerektiğini gösterir.
Precision ve recall nedir?
Önce hangi sonucu aradığımızı seçelim. Bu yazıda pozitif sınıf spam olsun. “Pozitif” sözcüğü burada iyi veya faydalı demek değildir; modelin bulmasını istediğimiz sınıfı ifade eder.
Precision: Verdiği alarmların kaçı doğru?
Precision (kesinlik), modelin “spam” dediği e-postaların gerçekten spam olan bölümünü ölçer. Sistem 100 iletiyi spam klasörüne attıysa, bunların kaçında doğru karar verdiğini sorarız. Normal bir e-postayı spam diye işaretlemek, yanlış alarmdır.
Precision = Doğru spam tahmini / Tüm spam tahminleri
Recall: Gerçek spamlerin kaçını buldu?
Recall (duyarlılık veya yakalama oranı), gerçekten spam olan e-postaların ne kadarını yakaladığımızı ölçer. Burada başlangıç noktamız modelin işaretledikleri değil, veri kümesindeki bütün spamlerdir. Spam bir iletiyi normal diye geçirmek, kaçırılan örnektir.
Recall = Yakalanan spam / Gerçek spamlerin tamamı
Aradaki farkı iki soruyla hatırlayın: Precision için “Spam dediklerinin kaçı spam?”, recall için “Spamlerin kaçını buldu?”
1.000 e-posta ile adım adım hesaplama
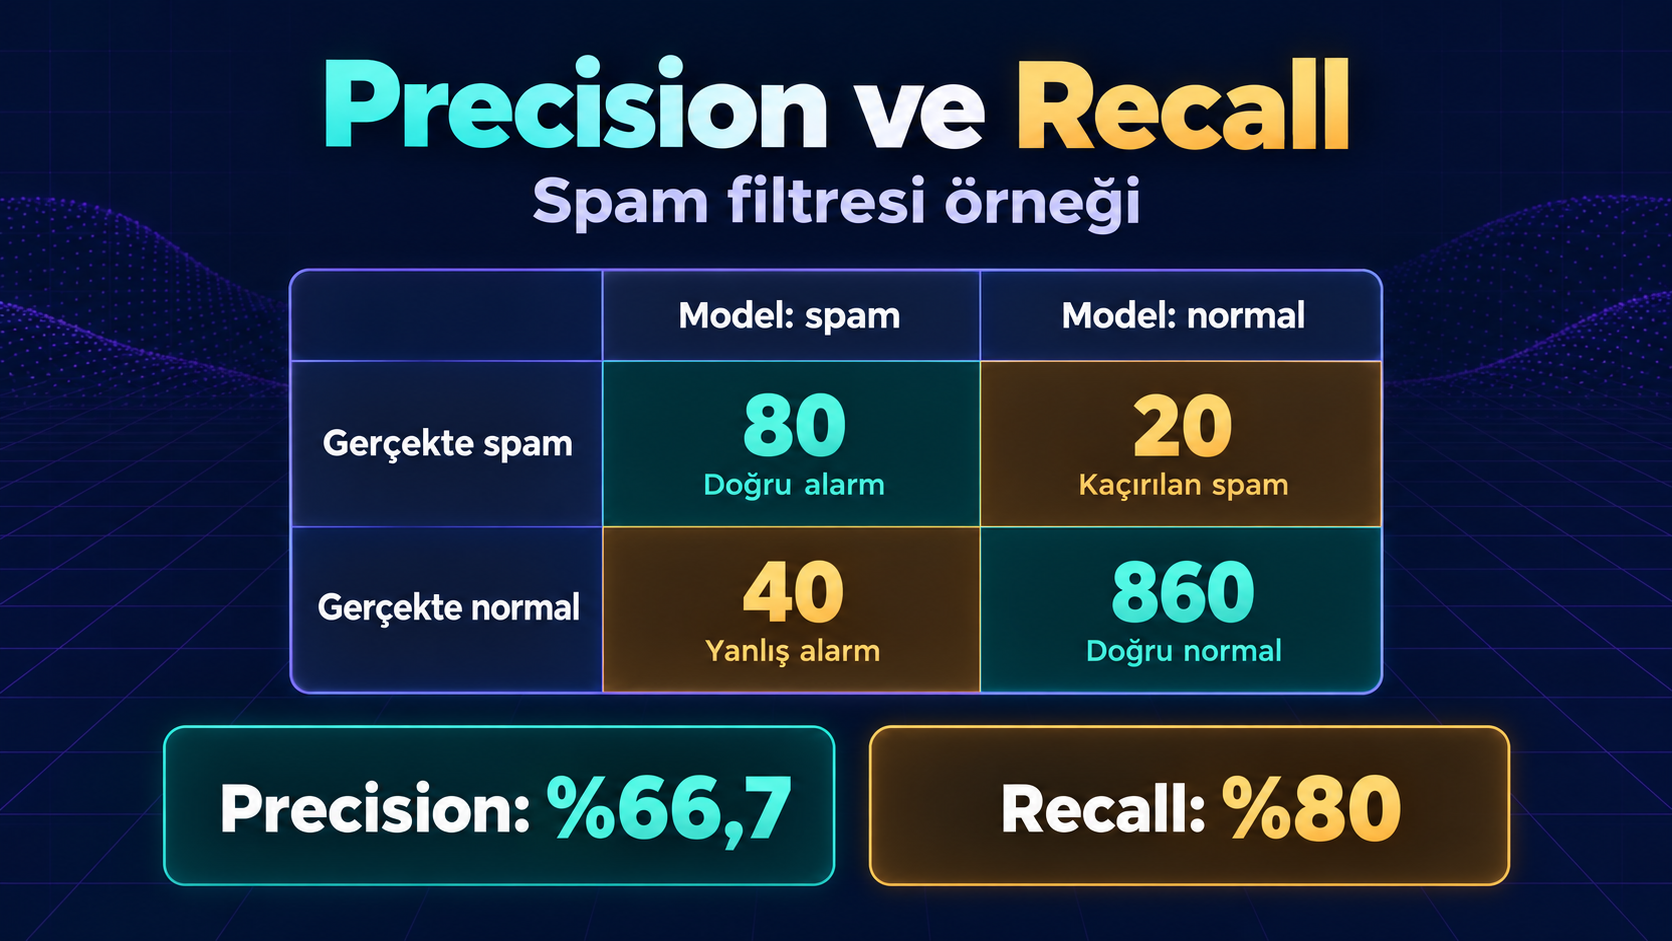
Şimdi farklı bir örnek kullanalım: 100 spam ve 900 normal e-posta içeren, toplam 1.000 iletilik bir test kümesi. Aşağıdaki sayılar anlatımı kolaylaştırmak için hazırlanmış örnek sonuçlardır.
| Gerçek durum | Model: spam | Model: normal |
|---|---|---|
| Gerçekte spam | 80: doğru alarm (TP) | 20: kaçırılan spam (FN) |
| Gerçekte normal | 40: yanlış alarm (FP) | 860: doğru normal (TN) |
Bu tabloya confusion matrix, yani karışıklık matrisi denir. Her tahmini, gerçek etiketle yan yana değerlendirir. TP ve TN doğru kararları; FP ve FN ise iki farklı hatayı gösterir.
- Precision: Model 80 + 40 = 120 e-postaya spam dedi. Bunların 80 tanesi gerçekten spam. Sonuç: 80 / 120 ≈ %66,7.
- Recall: Gerçekte 80 + 20 = 100 spam vardı. Model bunların 80 tanesini buldu. Sonuç: 80 / 100 = %80.
- Accuracy: 80 + 860 = 940 karar doğru. Sonuç: 940 / 1.000 = %94.
Yüzde 94 doğruluk kulağa güçlü geliyor. Fakat spam klasörüne gönderilen her üç e-postanın yaklaşık biri normal. Ayrıca gerçek spamlerin beşte biri kaçırılıyor. Precision ve recall, genel puanın göstermediği bu ayrıntıları açığa çıkarır.
F1 puanı ne işe yarar?
F1 puanı, precision ve recall değerlerini birlikte özetleyen harmonik ortalamadır. İki ölçüte eşit ağırlık verir. Hesaplamayı doğrudan tablodaki sayılarla da yapabilirsiniz:
F1 = 2 × TP / (2 × TP + FP + FN)
Örneğimizde F1 = 160 / (160 + 40 + 20) ≈ %72,7. Ölçütlerden biri düşükse diğeri çok yüksek olsa bile F1 bunu güçlü biçimde yansıtır. Bununla birlikte F1, doğru normal kararları (TN) doğrudan hesaba katmaz. Bu nedenle tek başına bütün ürün davranışını anlatmaz.
Hangisini önceliklendirmelisiniz?
Kararı, hatanın kullanıcıya etkisine göre verin. Örneğin önemli bir müşteri e-postasını kaybetmek ciddi bir sorunsa, spam kararlarında yüksek precision hedefleyebilirsiniz. Gelen kutusunda istenmeyen ileti kalmasını azaltmak istiyorsanız recall daha fazla önem kazanır. Her iki durumda da diğer ölçütü izlemeye devam edin.
Model bir spam skoru üretiyorsa, bu skoru karara çeviren bir eşik belirleyebilirsiniz. Eşiği düşürmek genellikle daha fazla iletiyi spam olarak işaretler: recall artabilir, yanlış alarmlar çoğalabilir. Eşiği yükseltmek daha az spam kararı üretir ve bazı spamleri kaçırabilir. Precision değişimi veri dağılımına bağlıdır; sonucu ölçerek karar verin.
Modelinizi değerlendirirken 5 pratik adım
- Aradığınız sınıfı yazın. Spam, olumsuz yorum veya belirli bir belge türü mü? “Pozitif” sınıf herkes için aynı anlama gelsin.
- Gerçek etiketleri kontrol edin. Hatalı etiketler, değerlendirme sonucunu da bozar. Emin olmadığınız örnekleri ayrıca inceleyin.
- Hata sayılarını rapora ekleyin. Yüzdelerin yanında TP, FP ve FN sayılarını paylaşın. Az sayıda örnek, yanıltıcı derecede yüksek veya düşük oranlar üretebilir.
- Eşiği ayrı verilerle seçin. Ayarları bir doğrulama kümesinde karşılaştırın. Son değerlendirmeyi, ayar seçerken kullanmadığınız test kümesinde yapın.
- Yeni örneklerde tekrar ölçün. Gerçek kullanımda ileti türleri değişebilir. Aynı ölçütleri zaman içinde takip edin ve yanlış karar örneklerini inceleyin.
Benzer bir değerlendirme ihtiyacı, yapay zekâ ile anomali tespiti sistemlerinde de ortaya çıkar: Bir alarmın doğruluğu ile önemli olayları yakalama oranı ayrı sorulardır.
Kendinizi deneyin: Küçük bir alıştırma
Bir filtre 10 spam yakalıyor, 2 normal e-postayı yanlış işaretliyor ve 5 spami kaçırıyor. Önce precision ve recall değerlerini kendiniz hesaplayın.
Yanıt: Precision = 10 / (10 + 2) ≈ %83,3. Recall = 10 / (10 + 5) ≈ %66,7. Burada modelin verdiği spam kararları çoğunlukla doğru; ancak gerçek spamlerin üçte birini kaçırıyor.
Sık sorulan sorular
Precision ile accuracy aynı şey mi?
Hayır. Accuracy bütün tahminlerdeki doğru kararların oranıdır. Precision ise seçtiğiniz sınıfa ait tahminlerin doğruluğuna odaklanır.
Model hiç spam demiyorsa precision kaçtır?
Spam tahmini yoksa precision formülünün paydası sıfır olur ve matematiksel değer tanımsızdır. Bazı araçlar bunu 0 gibi bir değerle raporlayabilir. Raporunuzda hangi kuralın kullanıldığını açıkça belirtin.
Yüksek F1 puanı modelin hazır olduğunu gösterir mi?
Tek başına göstermez. Hangi hataların oluştuğunu, örneklerin gerçek kullanımı temsil edip etmediğini ve sonuçların farklı veri gruplarında nasıl değiştiğini de inceleyin.
Kaynaklar: Google: Sınıflandırma ölçütleri, scikit-learn: Precision ve recall, scikit-learn: Karışıklık matrisi, scikit-learn: F1 puanı.
1 yorum