Teknik not
Multimodal Yapay Zekâ Nedir? Metin, Görsel ve Ses Rehberi
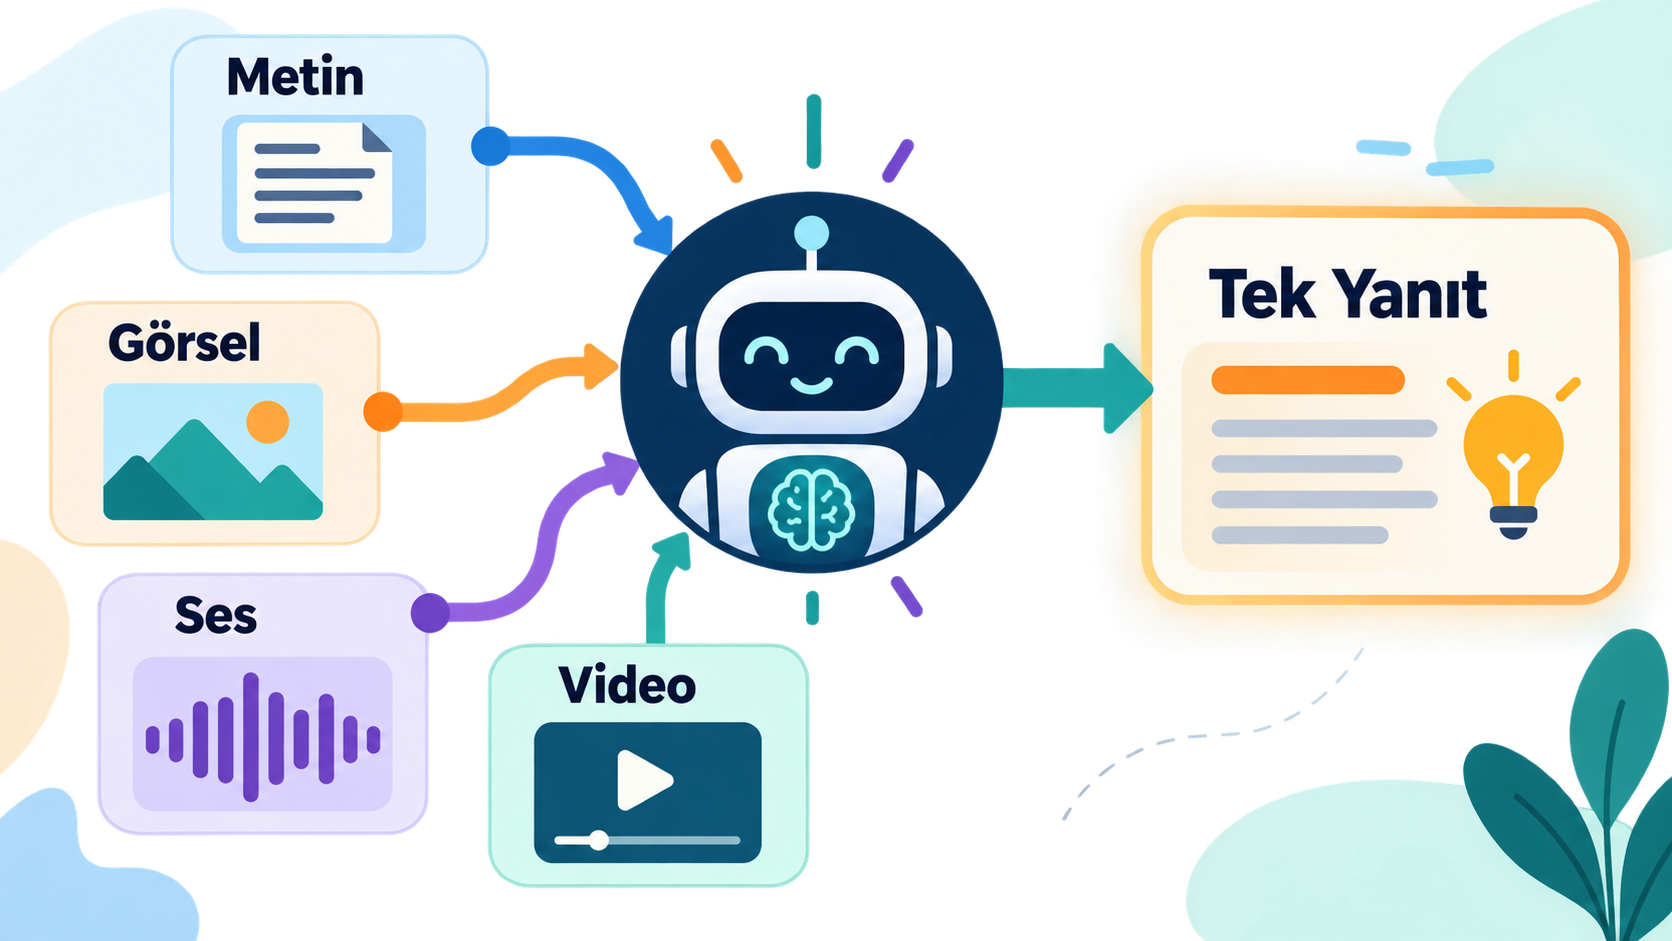
Multimodal yapay zekâ nedir? Multimodal yapay zekâ; metin, görsel ve ses gibi farklı veri türlerini birlikte anlayabilen yapay zekâ sistemidir. Yani bu sistemlere yalnızca yazı yazmak zorunda kalmazsınız. Bir fotoğraf gönderebilir, sesli soru sorabilir ve bütün bu bilgileri aynı istekte birleştirebilirsiniz.
Örneğin bir ürünün fotoğrafını yükleyip “Bu ürünün güçlü ve zayıf yönlerini anlat” dediğinizde model görüntüyü inceler ve sorunu metin olarak yanıtlar. Bu rehberde multimodal yapay zekânın ne olduğunu, nasıl çalıştığını ve günlük hayatta nasıl kullanılabileceğini basit bir dille öğreneceksiniz.
Multimodal yapay zekâ nedir?
“Multimodal” kelimesi, birden fazla iletişim biçiminin veya veri türünün birlikte kullanılması anlamına gelir. Multimodal yapay zekâ da metin, görsel, ses ve bazı sistemlerde video gibi farklı girdileri tek bir bağlam içinde işleyebilir.
Klasik bir metin tabanlı chatbot yalnızca yazdığınız kelimelere odaklanır. Multimodal bir model ise yazdığınız açıklamayı, eklediğiniz fotoğrafı ve ses kaydını birlikte değerlendirerek daha zengin bir cevap üretmeye çalışır.
Buradaki önemli nokta şudur: Her multimodal model her veri türünü aynı anda desteklemez. Bazı modeller metin ve görseli anlayabilir, bazıları sese de yanıt verebilir. Bir sistemi kullanmadan önce desteklediği giriş ve çıkış türlerini kontrol etmek gerekir.
“Mod” ne demek?
| Veri türü | Model neyi inceler? | Basit örnek |
|---|---|---|
| Metin | Kelimeleri, cümleleri ve anlam ilişkilerini | Bir e-postayı özetlemek |
| Görsel | Nesneleri, renkleri, düzeni ve görsel ipuçlarını | Bir grafiği açıklamak |
| Ses | Konuşmayı, kelimeleri ve ses akışını | Toplantı kaydını yazıya çevirmek |
| Video | Görüntü ile sesin zaman içindeki ilişkisini | Bir eğitim videosundaki adımları çıkarmak |
Bu veri türlerinin her biri bir “mod” olarak düşünülebilir. Model, modları tek tek değerlendirdikten sonra aralarındaki ilişkiyi kurar. Böylece yalnızca tek bir parçaya değil, isteğin tamamına bakabilir.
Multimodal yapay zekâ nasıl çalışır?
- Girdiler alınır: Kullanıcı metin, fotoğraf, ses veya video gibi içerikleri sisteme gönderir.
- İçerikler analiz edilir: Model görseldeki nesneleri, seste geçen kelimeleri ve metindeki anlamı ayrı ayrı inceler.
- Bağlam birleştirilir: Farklı girdiler arasındaki ilişki kurulur. Fotoğraf, açıklama ve sesli soru aynı sorunun parçaları hâline gelir.
- Yanıt oluşturulur: Model elde ettiği bağlama göre metin, ses veya desteklenen başka bir çıktı üretir.
Basit bir örnek düşünelim: Bir faturanın fotoğrafını gönderip “Toplam tutarı ve son ödeme tarihini bul” diyorsunuz. Sistem önce görüntüdeki yazıları okur, sonra tarih ve para alanlarını ayırır, son olarak da size kısa bir cevap verir. Görseldeki yazıyı metne çevirmek için kullanılan OCR yaklaşımını ayrıca OCR rehberinde anlattım.
Multimodal yapay zekâ ile normal chatbot arasındaki fark
Normal bir chatbot çoğunlukla yazılı soruya yazılı cevap verir. Multimodal sistemlerde ise soru ve cevap biçimi daha esnektir:
- Bir fotoğrafı açıklayabilir.
- Bir ekran görüntüsündeki hatayı bulmaya yardımcı olabilir.
- Sesli konuşmayı yazıya çevirebilir.
- Grafik veya tablo içindeki eğilimi özetleyebilir.
- Metin ile görseli karşılaştırabilir.
Bu, modelin her zaman doğru olduğu anlamına gelmez. Görsel bulanıksa, ses anlaşılmıyorsa veya soru belirsizse cevap da hatalı olabilir. Multimodal özellik, yalnızca daha fazla veri türü sunar; doğrulama sorumluluğunu ortadan kaldırmaz.
Multimodal yapay zekâ nerelerde kullanılır?
- Müşteri desteği: Kullanıcı, yaşadığı sorunun ekran görüntüsünü ve kısa açıklamasını birlikte gönderebilir.
- Eğitim: Öğrenci bir sorunun fotoğrafını yükleyip adım adım açıklama isteyebilir.
- Erişilebilirlik: Görseldeki nesnelerin veya tabelaların açıklanmasına yardımcı olabilir.
- Belge işleme: Fatura, form ve sözleşmelerdeki alanlar çıkarılabilir.
- Toplantı ve içerik üretimi: Ses kaydı özetlenebilir, görseller için açıklama hazırlanabilir.
- Yazılım geliştirme: Bir hata ekranı veya taslak arayüz üzerinden iyileştirme önerileri alınabilir.
- Ürün arama: Kullanıcı, beğendiği bir ürünün fotoğrafını göstererek benzer özellikleri sorabilir.
Günlük hayatta kullanmak için 5 basit örnek
- Fotoğrafı açıkla: “Bu görselde ne görüyorsun? Önemli ayrıntıları maddeler hâlinde yaz.”
- Belgeden bilgi çıkar: “Bu faturadaki firma adı, tarih ve toplam tutarı tabloya aktar.”
- Grafiği yorumla: “Bu grafikteki en yüksek ve en düşük değerleri basitçe anlat.”
- Ses kaydını özetle: “Bu konuşmadaki kararları ve yapılacak işleri ayır.”
- Görsel ile metni karşılaştır: “İlan metni fotoğraftaki ürünle uyuşuyor mu? Eksik bilgileri belirt.”
İyi sonuç almak için yalnızca “Buna bak” demek yerine ne istediğinizi belirtin. Çıktının biçimini de yazabilirsiniz: “Kısa bir özet oluştur”, “Üç maddede açıkla” veya “Tablo olarak ver” gibi ifadeler modeli yönlendirir.
Multimodal yapay zekâ kullanırken 7 pratik ipucu
- Amacınızı net yazın: Modelden açıklama mı, özet mi, karşılaştırma mı istediğinizi belirtin.
- Görseli kaliteli gönderin: Bulanık, çok karanlık veya aşırı küçük görseller hata riskini artırır.
- Önemli alanı tarif edin: “Görselin sağ üstündeki tarih alanına odaklan” gibi yönlendirmeler yapın.
- Yanıt biçimini belirleyin: Liste, tablo, kısa paragraf veya JSON formatı isteyebilirsiniz.
- Belirsizliği sorun: “Emin olmadığın noktaları ayrıca belirt” cümlesi kontrolü kolaylaştırır.
- Kritik bilgileri doğrulayın: Para, tarih, sağlık, hukuk ve kimlik bilgilerini tek başına modele bırakmayın.
- Gizliliği koruyun: Kişisel veya ticari belge yüklemeden önce servisin veri kullanım politikasını okuyun.
Multimodal yapay zekânın sınırları nelerdir?
Bir model görüntüdeki her ayrıntıyı göremez veya sesi her zaman doğru anlayamaz. Düşük çözünürlük, kötü ışık, farklı açı, el yazısı, arka plan gürültüsü ve karmaşık grafikler hata oranını yükseltebilir.
Ayrıca model bazen görselde olmayan bir ayrıntıyı varmış gibi anlatabilir. Bu nedenle özellikle belge, fatura, güvenlik kamerası veya teknik çizim gibi alanlarda “model söyledi, demek ki doğrudur” yaklaşımı güvenli değildir.
Hassas veriler için bir başka sınır da veri güvenliğidir. Fotoğraf ve ses dosyaları kişisel bilgi içerebilir. Gereksiz yüzleri, adresleri, telefon numaralarını veya şirket sırlarını paylaşmayın; mümkünse yüklemeden önce maskeleyin.
Basit bir multimodal yapay zekâ iş akışı
Metin + Görsel + Ses
→ İçerikleri kontrol et
→ Modelden tek bir görev iste
→ Yanıtı doğrula
→ Gerekirse insan onayı al
→ Sonucu iş akışına aktar
Bu akışta en önemli adım, modelden önce girdileri kontrol etmek ve modelden sonra çıktıyı doğrulamaktır. Küçük bir deneme seti hazırlayıp farklı görsel ve ses kaliteleriyle test yapmak, gerçek kullanımda sürprizleri azaltır.
Sık sorulan sorular
Multimodal yapay zekâ sadece görsel mi anlar?
Hayır. Multimodal sistemler destekledikleri özelliklere göre metin, görsel, ses ve video gibi farklı veri türlerini işleyebilir. Her modelin yetenekleri aynı değildir.
Multimodal yapay zekâ her görseli doğru yorumlar mı?
Hayır. Görüntü kalitesi, soru biçimi ve görselin karmaşıklığı sonucu etkiler. Kritik bilgileri mutlaka insan kontrolünden geçirin.
Multimodal yapay zekâ ile normal yapay zekâ arasındaki fark nedir?
Normal olarak adlandırılan metin tabanlı sistemler çoğunlukla yazılı girdilerle çalışır. Multimodal sistemler ise birden fazla veri türünü aynı istekte birleştirebilir.
Görsel veya ses yüklemek güvenli midir?
Güvenlik kullandığınız servisin politikalarına ve ayarlarına bağlıdır. Kişisel, finansal veya ticari bilgileri paylaşmadan önce saklama ve kullanım koşullarını inceleyin.
Sonuç
Multimodal yapay zekâ, metin, görsel ve ses gibi farklı veri türlerini birlikte anlayarak daha doğal bir etkileşim sunar. Fotoğraf açıklama, belge işleme, ses kaydı özetleme ve erişilebilirlik gibi birçok alanda faydalı olabilir.
En iyi sonuç için görevi net tanımlayın, kaliteli veri gönderin ve cevabı doğrulayın. Multimodal yapay zekâyı bir karar verici değil, doğru yönlendirildiğinde size yardımcı olan güçlü bir araç olarak kullanın.