Teknik not
Yapay Zekâda Model Quantization Nedir? Basit ve Uygulamalı Rehber
Güçlü bir yapay zekâ modelini kendi bilgisayarında çalıştırmak istiyorsun ama model belleğe sığmıyor mu? Model quantization, büyük modelin sayısal değerlerini daha az yer kaplayan biçimde saklayarak bu ihtiyacı azaltmaya yardımcı olur. Böylece bazı modelleri daha az bellekle çalıştırmak mümkün olabilir. Peki bunun kaliteye etkisi nedir ve hangi modeli seçmelisin? Bu rehberde konuyu basit örneklerle anlatıyorum.
Model quantization nedir?
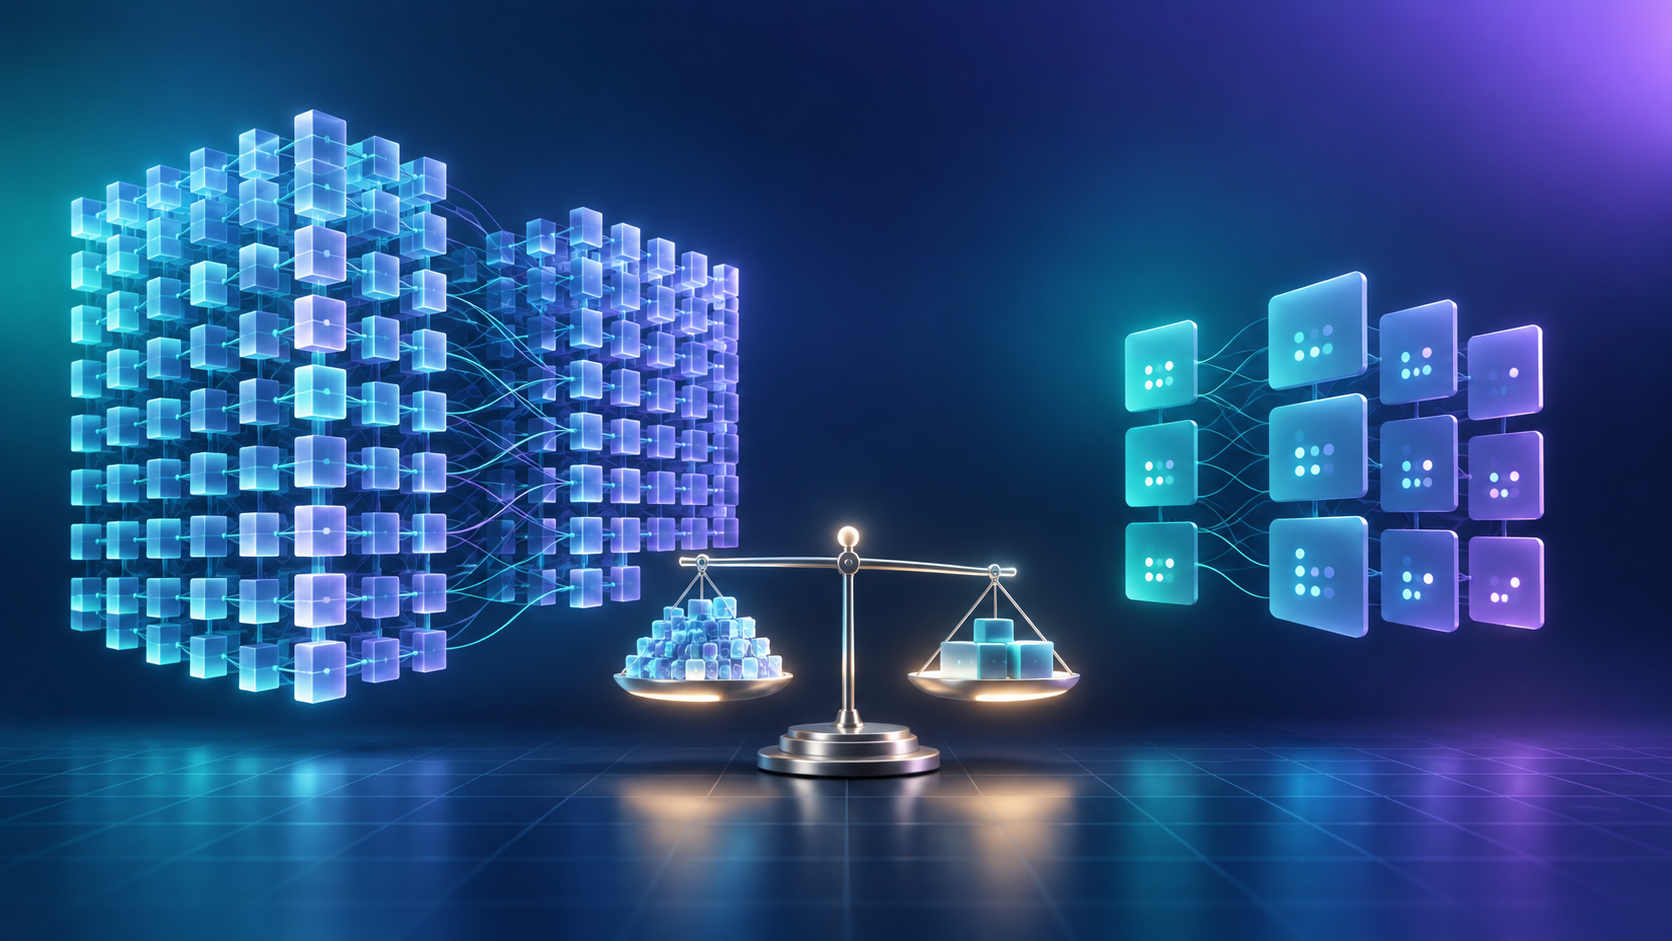
Yapay zekâ modeli, eğitim sırasında çok sayıda sayısal değer öğrenir. Bu değerlere model ağırlıkları denir. Quantization, modelin bu ağırlıkları daha düşük hassasiyetle göstermesini sağlar. Böylece model dosyası ve çalıştırmak için gereken bellek küçülebilir.
Bunu uzun bir sayıyı daha kısa yazmaya benzetebilirsin. Örneğin 3,14159 yerine 3,14 yazmak daha az yer kaplar; ancak değer artık tam olarak aynı değildir. Model quantization da çok sayıda değeri daha kompakt biçimde saklar. Amaç, boyutu azaltırken modelin işini ne kadar iyi yaptığını mümkün olduğunca korumaktır.
Quantization model belleğini nasıl azaltır?
Öncelikle, bilgisayar belleğinde bir sayıyı saklamak için belirli sayıda bit kullanırız. Model ağırlıklarını yüksek hassasiyetle sakladığımızda daha fazla alan gerekir. Buna karşılık daha düşük bitli bir biçim her ağırlığın kapladığı alanı azaltabilir. Örneğin 32 bitlik gösterimden 8 bitli gösterime geçersek yalnızca ağırlıklar için kabaca dörtte bir alan kullanırız. Yine de gerçek model dosyası bu oran kadar küçülmeyebilir. Çünkü pakette ek bilgiler ve farklı biçimde saklanan parçalar da yer alır.
İnternette 4-bit model, 8-bit quantization veya Q4 gibi ifadeler görebilirsin. Bunlar kullanılan sayısal gösterimin türü hakkında ipucu verir. Daha düşük bit sayısı genellikle daha küçük ağırlıklar demektir; fakat Q4 etiketi, her modelde aynı kaliteyi veya aynı dosya boyutunu garanti etmez. Quantization yöntemleri ve dosya biçimleri değişebilir.
Yapay zekâ modelini quantize etmenin faydaları
- Daha az bellek: Model, daha önce belleğe sığmadığı bir bilgisayarda çalışabilir.
- Daha küçük dosya: İndirme ve disk alanı ihtiyacı azalabilir.
- Yerel kullanım: Uyumlu bir model, desteklenen araçlarla bilgisayarda çalıştırılabilir; her kullanım için uzak bir sunucuya bağlanmak gerekmez.
- Olası hız artışı: Bazı işlemci ve grafik kartları düşük hassasiyetli işlemleri daha hızlı yapabilir.
Ancak bu sonuçlar donanıma, kullandığın yazılıma ve quantization biçimine bağlıdır. Küçük dosya her zaman daha hızlı yanıt veya daha düşük toplam bellek kullanımı sağlamaz. Ayrıca sohbet uzadıkça gereken bellek de artabilir.
Model quantization kalitenin düşmesine yol açar mı?
Bir miktar fark oluşabilir; çünkü quantization sayıları yaklaşık değerlerle gösterir. Fark, yönteme ve modele göre değişir. Günlük görevlerde bu farkı anlamak zor olabilir. Buna karşılık kod üretimi, uzun akıl yürütme, Türkçe anlatım veya özel alan bilgisi isteyen işlerde cevapları dikkatle karşılaştır.
Bu nedenle “en küçük dosya en iyisidir” diye düşünme. Daha fazla sıkıştırma bellek ihtiyacını düşürebilir; ancak bazı görevlerde doğruluğu veya tutarlılığı da azaltabilir. Senin için en uygun model, bilgisayarında çalışan ve kendi denemelerinde yeterli kaliteyi veren modeldir.
Quantization modeli otomatik olarak hızlandırır mı?
Hayır, hız artışı garanti değildir. Donanım düşük bitli işlemleri iyi destekliyorsa model hızlanabilir. Ancak bazı sistemlerde ek işlemler beklenen faydayı azaltır. Bu nedenle gerçek yanıt süresini kullanacağın uygulama ve bilgisayarda ölç. Aynı soruları, aynı ayarlarla ve benzer koşullarda deneyerek karşılaştır.
Q4, Q5 ve Q8 arasında nasıl seçim yapılır?
Bu adlar quantization türlerini tanımlayan etiketlerdir. Genel bir başlangıç kuralı olarak daha düşük bitli seçenekler daha az yer kaplama eğilimindedir; daha yüksek hassasiyetli seçenekler modelin özgün davranışını daha iyi koruyabilir. Fakat yöntem adlarının ayrıntısı yazılıma göre değişir. Örneğin GGUF kullanan bazı uygulamalarda Q4_K_M gibi daha uzun adlar bulunur. Bunları tek başına kalite puanı gibi okumamak gerekir.
Seçim yaparken şu sırayı izle:
- Bilgisayarındaki kullanılabilir RAM veya grafik belleğini kontrol et.
- Kullandığın çalıştırma aracının desteklediği model biçimini öğren.
- Donanımına uygun, güvenilir kaynaktan alınmış bir quantized sürüm seç.
- Aynı beş-on örnek isteği hem mümkünse özgün hem de sıkıştırılmış modelde dene.
- Yanıt kalitesini, gecikmeyi ve bellek kullanımını birlikte karşılaştır.
Deneme sorularına kendi kullanımını yansıtan Türkçe örnekler de ekle. Bir sohbet modelini yalnızca kısa İngilizce sorularla değerlendirmek, Türkçe kullanımındaki farkları göstermeyebilir. Yazım, kod, özet veya sınıflandırma gibi hangi iş için kullanacaksan ona uygun testler hazırla.
Quantization, model damıtma ve fine-tuning farkı
Bu terimler model boyutunu veya davranışını değiştirebilir; ancak aynı anlama gelmez. Quantization, mevcut ağırlıkları daha az hassas sayılarla gösterir. Model damıtma, öğretmen modelin örnekleriyle daha küçük bir öğrenci modeli eğitir. Fine-tuning ise hazır modeli yeni örneklerle eğiterek belirli bir işe uyarlar. Model damıtmanın temel fikrini model damıtma rehberinde ayrıca anlattım.
Model quantization için kısa kontrol listesi
- Dosya adındaki Q4 veya Q8 bilgisini kalite garantisi olarak görme.
- İndirdiğin dosyanın model sürümüyle ve kullandığın araçla uyumunu doğrula.
- Sadece dosya boyutuna değil, gerçek çalışma belleğine de bak.
- Modeli kendi görevlerin ve Türkçe örneklerinle sınamadan üretimde kullanma.
- Yüksek riskli kararları tek başına yapay zekâ çıktısına bırakma.
Sık sorulan sorular
Quantization için modeli yeniden eğitmek gerekir mi?
Çoğu zaman hayır. Bir araç mevcut ağırlıkları uygun biçime dönüştürür; bu, modeli baştan eğitmek değildir. Ancak kullandığın araç dönüşüm veya kalibrasyon adımları isteyebilir.
Quantization modelin parametre sayısını azaltır mı?
Hayır. Quantization modeldeki ağırlıkların sayısını değiştirmez; her ağırlığın gösterim hassasiyetini ve kapladığı alanı azaltır. Parametre sayısını veya model mimarisini değiştirmek farklı yaklaşımlardır.
Quantized model internetsiz çalışır mı?
Quantization tek başına internet bağlantısını belirlemez. Model dosyasını bilgisayarına indirip yerel çalıştırmayı destekleyen bir araç kullanırsan internet olmadan çalıştırabilirsin. Modeli indirmek veya harici hizmet kullanmak için bağlantı gerekir.
Her küçük model quantized mıdır?
Hayır. Küçük model daha az parametreyle eğitilmiş olabilir. Quantized model ise ağırlıklarını daha az yer kaplayan biçimde saklar. Geliştiriciler iki yaklaşımı aynı projede birlikte kullanabilir.
Sonuç
Yapay zekâda model quantization, bir modeli daha az bellekle çalıştırma şansı sunan pratik bir yöntemdir. Bunun karşılığında cevap kalitesi değişebilir ve hız artışı kullandığın donanıma bağlıdır. Önce donanımına uygun bir sürüm seç, sonra gerçek sorularınla kaliteyi ve performansı ölç. İyi seçim, yalnızca en küçük dosyayı bulmak değil; ihtiyacını yeterli kaliteyle karşılayan modeli bulmaktır.