Teknik not
Yapay Zekâda Veri Sızıntısı Nedir? Testteki %99 Başarıya Dikkat
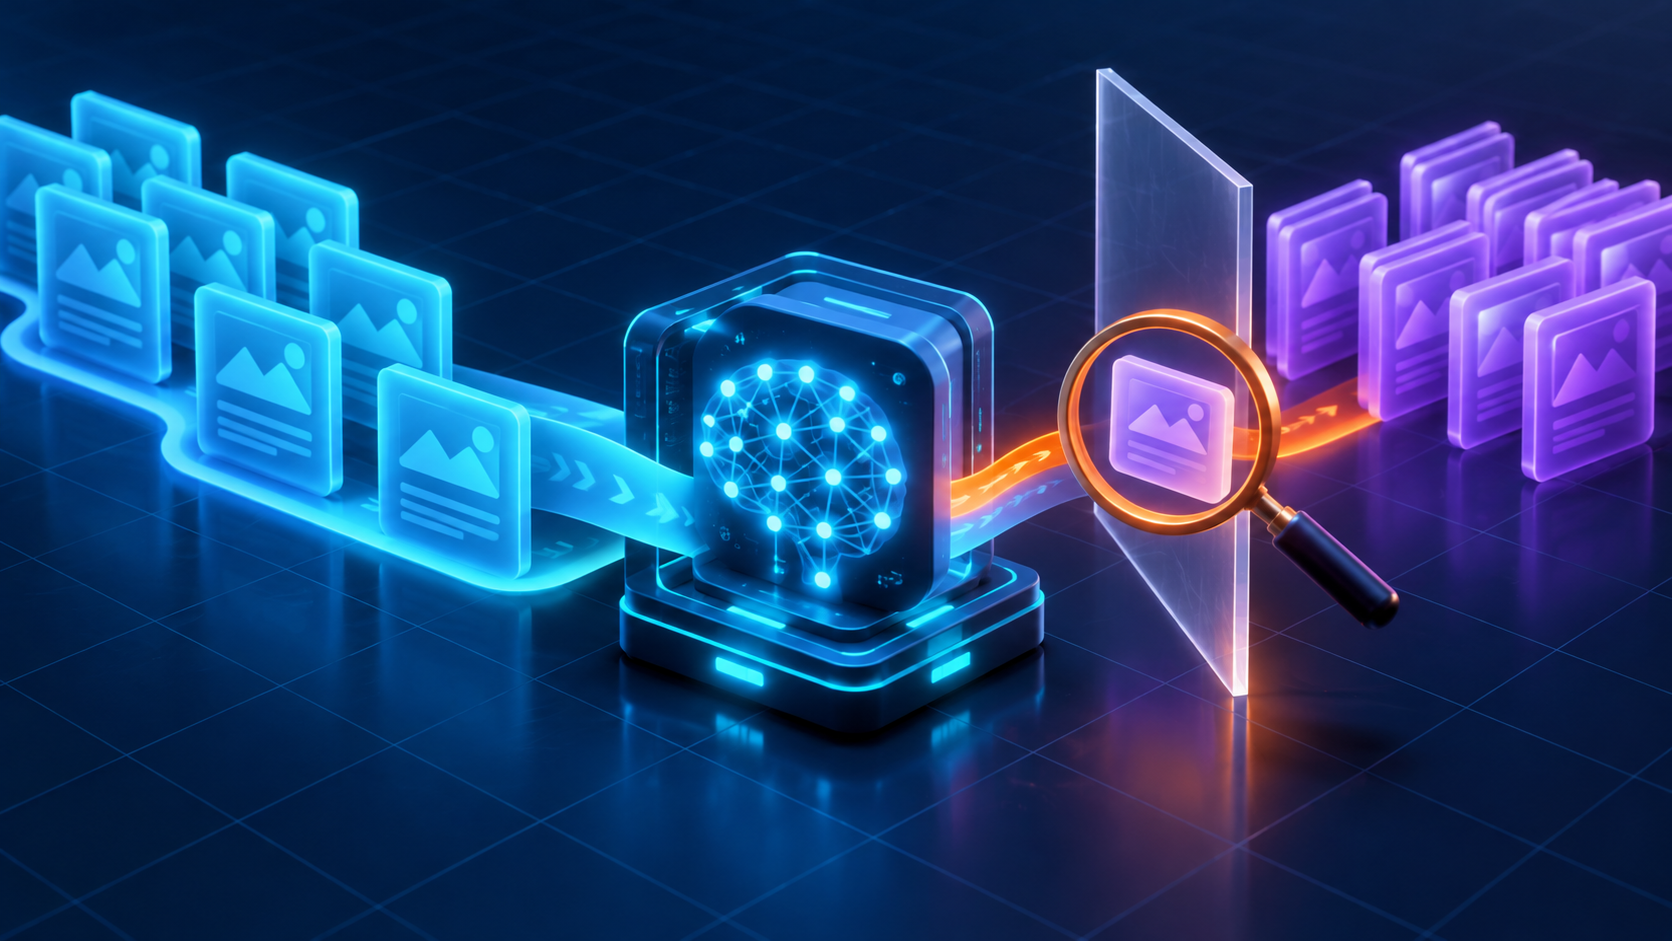
Yapay zekâda veri sızıntısı, testte yüzde 99 başarılı görünen bir modeli gerçek hayatta yanıltıcı hâle getirebilir. Test örnekleri ya da gelecekte bilinecek bilgiler fark etmeden modelin eğitimine karışırsa ölçüm güvenilir olmaz. Bu sorunun nasıl oluştuğunu ve nasıl önleneceğini basit örneklerle görelim.
Yapay zekâda veri sızıntısı nedir?
Veri sızıntısı, model hazırlanırken tahmin anında bilinmemesi gereken bir bilginin kullanılmasıdır. Bazen test kümesindeki cevaplar eğitim adımlarına karışır; bazen de model, gelecekte oluşacak bir bilgiyi tahmin için kullanır. Sonuç kâğıt üzerinde etkileyici görünür, ancak yeni örneklerde aynı başarıyı vermeyebilir.
Buradaki “sızıntı”, tek başına kişisel verilerin dışarıya açıldığı bir güvenlik ihlali anlamına gelmez. Konu, modelin başarısını ölçerken eğitim ve değerlendirme bilgilerinin birbirine karışmasıdır.
Basit örnek: kopya e-postalar
Bir ekip, e-postaların spam olup olmadığını tahmin eden bir model hazırlıyor. Veriyi rastgele eğitim ve test kümelerine ayırıyor. Ancak aynı e-postanın iki kopyası da farklı kümelere düşüyor. Model, eğitimde gördüğü e-postayı testte tekrar görünce onu tanıyabiliyor. Test puanı çok yüksek çıkıyor; fakat daha önce görmediği yeni e-postalarda başarı düşüyor.
Benzer bir sorun geleceği tahmin ederken de yaşanabilir. Örneğin gelecek hafta hangi müşterinin aboneliğini iptal edeceğimizi tahmin ediyoruz. Modele “abonelik iptal tarihi” sütununu verirsek cevap zaten sütunun içinde bulunur. Bu bilgi tahmin anında mevcut olmadığı için gerçekçi bir test yapmış olmayız.
Yapay zekâda veri sızıntısı en sık nasıl oluşur?
- Kopya kayıtlar: Aynı kişi, sipariş veya e-posta hem eğitimde hem testte yer alır.
- Gelecek bilgisi: Tahmin edilecek olaydan sonra oluşan bir alan, modele girdi olarak verilir.
- Erken ön işleme: Ölçekleme, eksik değer doldurma veya özellik seçme işlemi veri bölünmeden önce tüm kayıtlarla öğrenilir.
- Test setine fazla bakmak: Her test sonucundan sonra modeli değiştirip aynı testte tekrar denemek, kararları o test kümesine göre şekillendirir.
Özellikle son iki hata kolayca gözden kaçar. Örneğin verinin ortalamasını hesaplarken test örneklerini de kullanmak, test kümesinden küçük de olsa bilgi taşır. scikit-learn’in veri sızıntısı rehberi, dönüşümlerin yalnızca eğitim verisinde öğrenilmesini ve aynı dönüşümün test verisine uygulanmasını öneriyor.
Yapay zekâda veri sızıntısını önlemek için 5 adım
- Tahmin anını tarif edin. Model hangi anda karar veriyor? O anda hangi bilgiler gerçekten hazır? Sonradan oluşan sütunları kullanmayın.
- Önce bölün, sonra işlem yapın. Veriyi eğitim ve test kümelerine ayırın. Ölçekleyici, eksik değer doldurucu veya özellik seçici gibi araçları sadece eğitim verisiyle öğrenin.
- Veriyi doğru seviyede ayırın. Aynı kişiye ait çok sayıda kayıt varsa satırları değil kişileri ayırın. Zaman tahmininde geçmişi eğitime, daha sonraki dönemi teste koyun.
- Ön işlemleri bir akışta tutun. scikit-learn gibi araçlardaki Pipeline yaklaşımı, eğitimde öğrenilen dönüşümün testte tutarlı uygulanmasına ve test bilgisinin eğitime sızmamasına yardım eder.
- Son test kümesini saklayın. Model seçeneklerini geliştirme verisiyle karşılaştırın; nihai testi en sonda, mümkün olduğunca bir kez kullanın. Test kümesiyle tekrar tekrar karar vermek onu da “eskitir”.
Google’ın makine öğrenmesi eğitiminde de eğitim, doğrulama ve test kümelerinin ayrı tutulması; testte eğitim örnekleriyle kopya kayıt bulunmaması öneriliyor. Model kalitesini daha geniş bir çerçevede ölçmek için LLM evals rehberine de göz atabilirsiniz.
Sık sorulan sorular
Veri sızıntısı ile kişisel veri sızıntısı aynı şey mi?
Hayır. Makine öğrenmesindeki veri sızıntısı, model hazırlanırken veya değerlendirilirken tahmin için haksız bir bilgi avantajı oluşmasıdır. Kişisel verilerin yetkisiz kişilere açılması ise ayrı bir gizlilik ve güvenlik sorunudur.
Yüksek test başarısı veri sızıntısı olduğunu kanıtlar mı?
Hayır. Yüksek başarı tek başına kanıt değildir; ama kopya kayıtları, gelecek bilgilerini ve veri bölme adımlarını kontrol etmek için iyi bir işarettir. Test kümesinin gerçek kullanım koşullarını temsil edip etmediğini de inceleyin.
Pipeline kullanmak tüm veri sızıntılarını önler mi?
Ön işleme kaynaklı birçok hatayı önlemeye yardımcı olur. Ancak yanlış zaman aralığı seçmek veya aynı kullanıcıyı hem eğitim hem testte tutmak gibi bölme hatalarını tek başına çözmez. Bölme kuralını da kullanım senaryosuna göre belirleyin.
Kısaca
Yapay zekâda veri sızıntısı, test sonuçlarını olduğundan iyi gösterip modelin gerçek kullanım performansını yanlış anlamamıza neden olabilir. Kopyaları kontrol edin, tahmin anında bulunmayacak bilgileri çıkarın, veriyi ön işlemeden önce doğru biçimde ayırın ve son test kümesini saklayın. Böylece modelin gerçekten yeni örneklerde ne kadar başarılı olduğunu daha dürüst ölçebilirsiniz.
Kaynaklar
- scikit-learn: Common pitfalls — Data leakage — sızıntının tanımı, ön işleme ve Pipeline kullanımı.
- Google for Developers: Dividing the original dataset — eğitim, doğrulama ve test kümeleri; kopya kayıtların kontrolü.