Teknik not
Yapay Zekâ Streaming Yanıt Nedir? API Rehberi
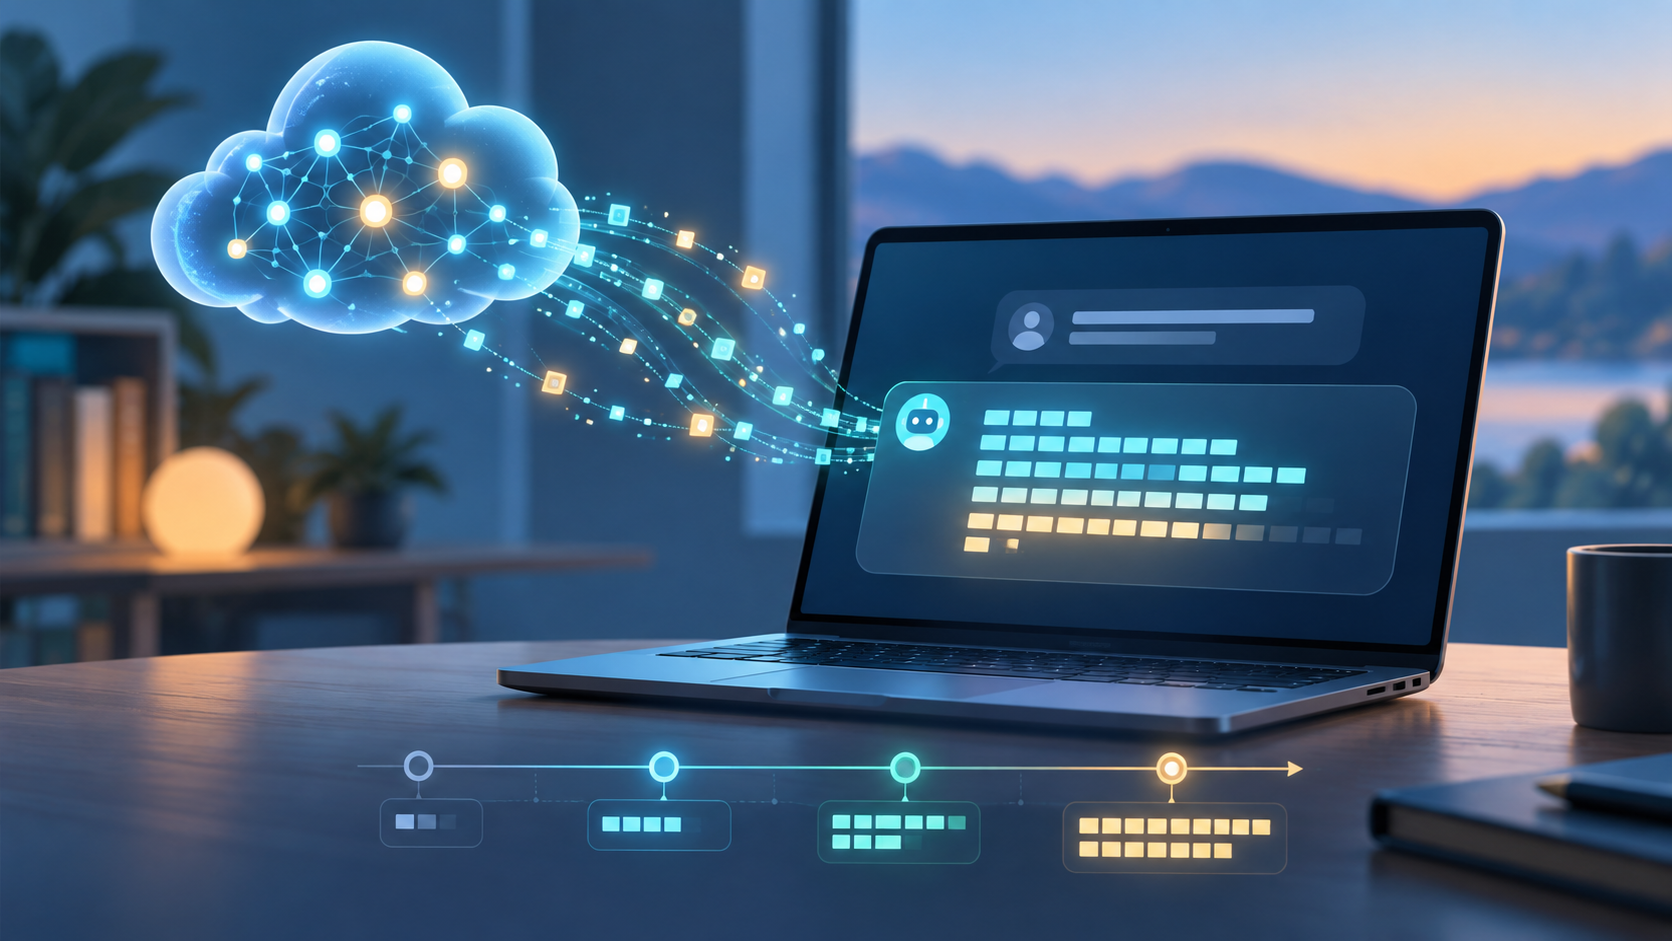
Bir yapay zekâ sohbetinde yanıtın tamamını beklemek yerine ilk cümlelerin ekranda görünmeye başladığını fark etmişsinizdir. Yapay zekâ streaming yanıt, modelin oluşturduğu metnin tamamlanmasını beklemeden parça parça uygulamaya iletilmesidir. Mesaj, yazılırken ekrana düşer; kullanıcı daha erken okumaya başlayabilir.
Bu rehberde akışın normal API yanıtından farkını, sunucu ile tarayıcı arasında nasıl taşındığını ve ölçerken nelere bakmanız gerektiğini anlatıyorum.
Streaming yanıt nasıl çalışır?
Normal bir istekte uygulama, model tüm yanıtı bitirene kadar bekler ve sonucu tek seferde alır. Streaming açık olduğunda sunucu, üretim sürerken gelen metin parçalarını istemciye aktarır. Parçalar çoğu zaman token veya kısa metin bloklarıdır; bunlar her zaman tam bir kelimeye denk gelmez.
- Tarayıcı isteği gönderir: Kullanıcının mesajı sizin uygulama sunucunuza gider.
- Sunucu model API’sini çağırır: Gizli API anahtarı sunucuda kalır ve yanıt akış olarak istenir.
- Metin parçaları iletilir: Sunucu gelen metin olaylarını tarayıcıya aktarır.
- Arayüz yanıtı büyütür: Her yeni parça aynı mesaj balonuna eklenir; tamamlanma veya hata ayrıca gösterilir.
OpenAI Responses API akışında metin parçaları response.output_text.delta gibi olaylarla gelir; tamamlanma da ayrı bir olaydır. Olay adları ve desteklenen akış türleri API’ye göre değişebilir. Güncel ayrıntılar için OpenAI Streaming API belgelerine bakın.
Normal yanıt ile streaming arasındaki fark
| Özellik | Normal yanıt | Streaming |
|---|---|---|
| İlk içerik | Yanıt tamamlanınca görünür. | Üretim sırasında parça parça görünür. |
| Algılanan bekleme | Kullanıcı boş bir ekran görebilir. | Arayüz daha erken geri bildirim verir. |
| Uygulama kodu | Tek yanıtı işler. | Akışı, bitişi ve olası hataları işler. |
| İçeriği denetleme | Tam yanıt önceden incelenebilir. | Kısmi içerik gösterildiği için denetim zorlaşabilir. |
Streaming, modelin mutlaka daha hızlı düşündüğü veya toplam işi daha kısa sürede bitirdiği anlamına gelmez. Temel fark, kullanılabilir ilk içeriğin ne zaman ekrana ulaştığıdır. Uzun yanıtların daha etkileşimli hissedilmesine yardımcı olur; tek cümlelik çok kısa yanıtlarda kazanç sınırlı olabilir.
Uygulamalı örnek: API akışını tarayıcıya iletmek
Güvenli mimaride tarayıcı doğrudan sağlayıcıya bağlanmaz. İstek önce sizin sunucunuza gelir; sunucu da sağlayıcıdan aldığı metin parçalarını tarayıcıya aktarır. Aşağıdaki Node.js ve Express örneği, OpenAI Responses API’den gelen metin olaylarını basit bir SSE akışına çevirir:
app.post("/api/chat/stream", async (req, res) => {
  res.setHeader("Content-Type", "text/event-stream; charset=utf-8");
  res.setHeader("Cache-Control", "no-cache, no-transform");
  res.setHeader("Connection", "keep-alive");
  res.flushHeaders?.();

  try {
    const stream = await openai.responses.create({
      model: "MODEL_ADI",
      input: req.body.message,
      stream: true,
    });

    for await (const event of stream) {
      if (event.type === "response.output_text.delta") {
        res.write("data: " + JSON.stringify({ delta: event.delta }) + "\n\n");
      } else if (event.type === "response.completed") {
        res.write("data: [DONE]\n\n");
        res.end();
        return;
      }
    }
    res.end();
  } catch (error) {
    res.write("event: error\ndata: {\"message\":\"Yanıt oluşturulamadı.\"}\n\n");
    res.end();
  }
});
MODEL_ADI yerine hesabınızda kullanabildiğiniz bir model adını yazın. Gerçek uygulamada isteği doğrulayın, kullanıcı başına hız sınırı koyun ve tarayıcı bağlantısı kesilirse üretimi durdurmayı değerlendirin. İstemci tarafında yanıt gövdesini akış olarak okuyup her delta parçasını mevcut mesaj alanına ekleyin. Ağ parçaları olay sınırlarıyla aynı anda gelmeyebilir; bu nedenle SSE ayrıştırıcısı eksik kalan son parçayı sonraki okumaya kadar tamponlamalıdır. SSE’de sunucu mesajları data: alanlarıyla iletilir ve olaylar boş bir satırla ayrılır. Ayrıntı için MDN’nin Server-Sent Events rehberini inceleyin.
İyi bir sohbet arayüzü için 5 pratik adım
- Boş yanıtı bekleme göstergesiyle değiştirin: İstek başlar başlamaz “Yanıt hazırlanıyor” durumunu gösterin.
- Parçaları tek mesaja ekleyin: Her parçayı yeni satır veya yeni balon yapmak yerine mevcut yanıtın sonuna ekleyin.
- Tamamlanmayı hata durumundan ayırın: Bağlantı kesildiğinde eksik yanıtı tamamlanmış gibi göstermeyin; yeniden deneme seçeneği sunun.
- Durdur düğmesi ekleyin: Kullanıcı yanıtı artık istemiyorsa isteği iptal edebilsin ve sunucu da iptali sağlayıcıya iletmeyi değerlendirsin.
- İlk parçayı ve toplam süreyi ayrı ölçün: İlk görünür metne kadar geçen süreyi, yanıtın tamamlanma süresini ve bağlantı kopmalarını ayrı kaydedin.
Güvenlik ve hata durumları
Akışta ilk kelimeler henüz yanıtın tamamını temsil etmez. Bir hata oluşursa ekranda yarım kalmış bir cümle bulunabilir; arayüz bunu açıkça belirtmelidir. Ayrıca kısmi çıktıları üretim sırasında denetlemek, tamamlanmış bir metni denetlemekten daha zordur. OpenAI’nin belgesi bu noktayı özellikle vurgular. Hassas veya yüksek riskli kullanımda parçaları doğrudan göstermek yerine önce denetimden geçirmek, gecikmeli göstermek ya da streaming’i kapatmak daha uygun olabilir.
API anahtarını tarayıcı koduna koymayın. İstemciye yalnızca sizin sunucunuzun ürettiği, gerekli bilgilerle sınırlı akışı gönderin. Günlüklerde tam kullanıcı mesajlarını veya hassas yanıtları tutmanız gerekmiyorsa kaydetmeyin.
Kısa özet
Streaming yanıt, yapay zekâ metnini tamamlandıktan sonra değil, üretim sürerken parça parça gösterir. İyi bir uygulama; API anahtarını sunucuda tutar, akış olaylarını doğru tamponlar, tamamlanma ve hata durumlarını ayırır, ilk görünür yanıt süresini ölçer. Kısmi çıktının denetimini de tasarıma baştan ekleyin.