Teknik not
KV Cache Nedir? LLM Yanıtlarını Nasıl Hızlandırır?
Bir sohbet botu uzun bir cevabı kelime kelime üretirken her adımda önceki konuşmayı baştan hesaplasaydı, yanıt vermesi gereksiz yere yavaşlardı. KV cache (KV önbelleği), büyük dil modellerinin bu tekrarı azaltmasına yardım eder: önceki token’lara ait bazı ara hesapları saklar ve yeni token üretilirken yeniden kullanır. Sonuç daha hızlı üretim olabilir; karşılığında bellek kullanılır.
KV cache nedir?
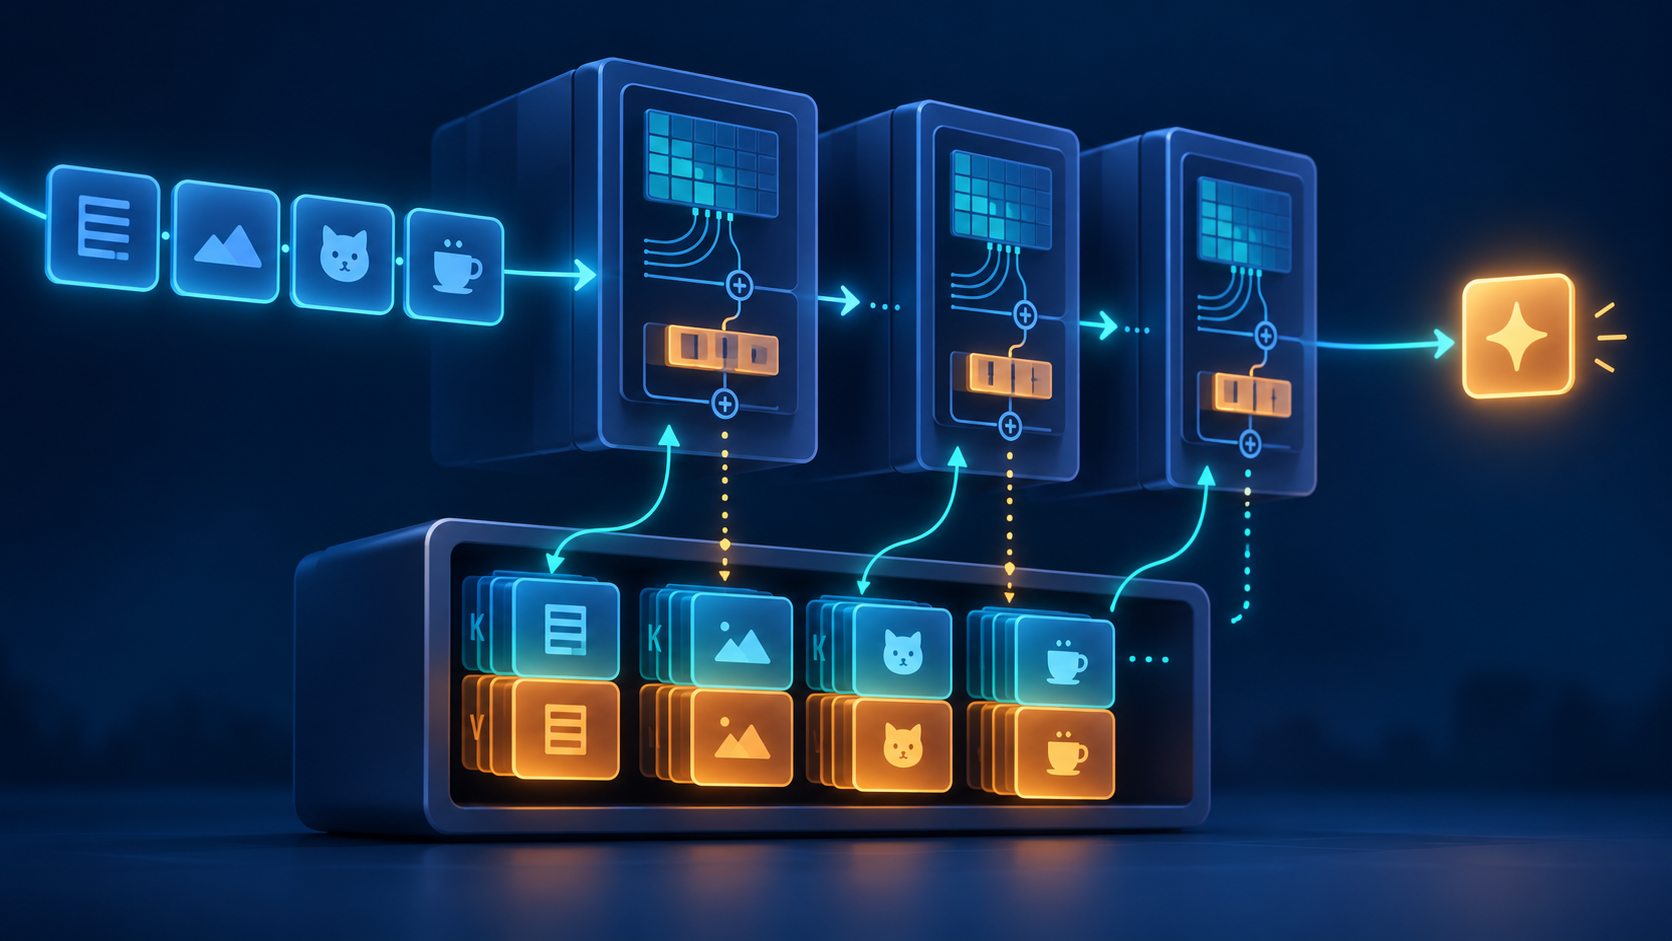
KV, Transformer modellerindeki key (anahtar) ve value (değer) ara hesaplarının kısaltmasıdır. Model, her katmanda token’lar arasındaki ilişkiyi hesaplarken bu değerlerden yararlanır. KV cache, üretilmiş token’ların key ve value sonuçlarını geçici bellekte tutar. Böylece model, sıradaki token için geçmiş token’ların aynı hesaplarını tekrar yapmak zorunda kalmaz.
Bir örnekle düşünelim
Uzun bir kitabı okurken her yeni cümlede önceki sayfaları baştan okumak yerine önemli notları yanında tuttuğunu düşün. Yeni cümleyi anlamak için bu notlara bakarsın. KV cache de modelin o anki üretim sürecinde önceki token’ların bazı hesaplarını yanında tutar. Bu benzetmede notlar kelimelerin kendisi değil, modelin dikkat mekanizmasında yeniden kullanılan ara değerlerdir.
KV cache nasıl çalışır?
- Model, istemi (prompt’u) işler ve ilk token’ı üretir.
- İşleme sırasında her katmanda oluşan key ve value değerleri cache’e eklenir.
- Sıradaki token hesaplanırken model, geçmiş token’ların saklanan değerlerini kullanır; yalnızca yeni adım için gereken hesapları ekler.
- Bu süreç cevap tamamlanana ya da belirlenen üretim sınırına ulaşana kadar sürer.
Cache genellikle tek bir yazışmanın üretimi boyunca kullanılan geçici durumdur; sohbet geçmişinin kalıcı hafızası değildir. Uygulama isteği bittiğinde bu belleğin ne zaman ve nasıl temizleneceği, kullanılan sunucuya ve çıkarım altyapısına bağlıdır.
Hız kazancı neden bellek maliyeti yaratır?
Önceki hesapları tekrar yapmamak üretim süresini azaltabilir. Ancak saklanan cache de RAM veya GPU belleğinde yer kaplar. Bellek ihtiyacı; bağlamın uzunluğu, modelin katman ve attention boyutları, aynı anda işlenen istek sayısı ve cache’in hangi hassasiyette tutulduğu gibi etkenlerle büyür. Bu nedenle uzun bağlamlı veya çok kullanıcılı bir serviste hız kazanırken GPU belleğinin dolduğunu görebilirsin.
Başlıca KV cache seçenekleri
- Dynamic cache: Üretim ilerledikçe büyür. Kullanımı kolaydır ve birçok araçta varsayılan seçenektir.
- Static cache: Önceden belirlenen kapasiteyi ayırır. Bazı derleme ve hızlandırma yöntemleriyle uyum sağlayabilir; ayrılan alanın tamamı kullanılmasa da bellek tutabilir.
- Quantized cache: Cache değerlerini daha az bit ile saklayarak bellek ihtiyacını azaltmayı hedefler. Hız ve çıktı kalitesi üzerindeki etkisini kendi modelinde ölçmek gerekir.
- Offloaded cache: Cache’in bir bölümünü GPU belleği yerine sistem belleğinde tutar. GPU alanı kazandırabilir, fakat veri aktarımı ek gecikme yaratabilir.
Uygulamanızda KV cache’i nasıl test edersiniz?
- Aynı model, donanım ve sabit istemlerle cache açık/kapalı veya farklı cache türlerini karşılaştır.
- İlk token’a kadar geçen süreyi ve devamındaki token üretim hızını ayrı ayrı ölç.
- GPU belleği kullanımını; kısa ve uzun bağlamlarda, ayrıca eşzamanlı istek sayısı artarken kaydet.
- Quantized gibi seçeneklerde yalnızca hıza değil, örnek cevapların kalitesine de bak.
- Gerçek kullanımına en yakın yükte dene. Tek bir kısa istemde iyi görünen sonuç, uzun sohbetlerde veya yoğun trafikte aynı olmayabilir.
KV cache ile prompt caching aynı şey mi?
Her ikisi de gereksiz tekrarları azaltmayı amaçlayabilir, ancak terimler her sistemde aynı anlama gelmez. KV cache çoğunlukla mevcut token üretimi sırasında attention katmanlarının ara değerlerini saklar. Prompt veya prefix caching ise bazı sistemlerde tekrar gelen istem başlangıcının yeniden işlenmesini önleyen daha üst düzey bir özelliktir; bunu KV değerlerini saklayarak da gerçekleştirebilir. Bu yüzden kullandığın altyapının dokümantasyonundaki tanıma bakmak önemlidir.
Sık sorulan sorular
KV cache modelin cevabını değiştirir mi?
Cache, normalde aynı hesapları yeniden kullanmak için vardır; amacı cevabın anlamını değiştirmek değildir. Ancak quantization gibi bellek tasarrufu yöntemlerinde olası kalite farkı, kullanılan model ve ayarlara göre test edilmelidir.
Daha büyük cache her zaman daha hızlı mı?
Hayır. Cache kapasitesini artırmak daha uzun bağlamlara veya daha çok eşzamanlı isteğe alan açabilir; fakat tek başına hız garantisi vermez. Donanım, aktarım maliyeti, model ve sunucu ayarları da sonucu etkiler.
KV cache nereden öğrenilir?
Hugging Face’in cache açıklaması, key/value değerlerinin üretim sırasında nasıl kullanıldığını; KV cache rehberi ise farklı cache türlerini anlatır. Uygulama ayrıntıları kullandığın kütüphane ve modele göre değişebilir.
Kısaca: KV cache, LLM’in geçmiş token hesaplarını tekrar kullanarak üretimi hızlandırmasına yardım eder. Doğru seçimi yapmak için hız, bellek kullanımı ve kendi iş yükündeki cevap kalitesini birlikte ölç.