Teknik not
Federated Learning Nedir? Veriyi Taşımadan Model Eğitimi
Kişisel veriyi ortak bir veri merkezinde toplamadan model geliştirmek mümkün mü? Federated learning (birleşik öğrenme), farklı cihaz veya kurumların kendi verileri üzerinde yerel eğitim yapıp model güncellemelerini birleştirmesini sağlar. Böylece ham örneklerin merkezi sunucuya gönderilmesi gerekmeyebilir. Ancak bu yaklaşım tek başına gizlilik garantisi vermez.
Federated learning nasıl çalışır?
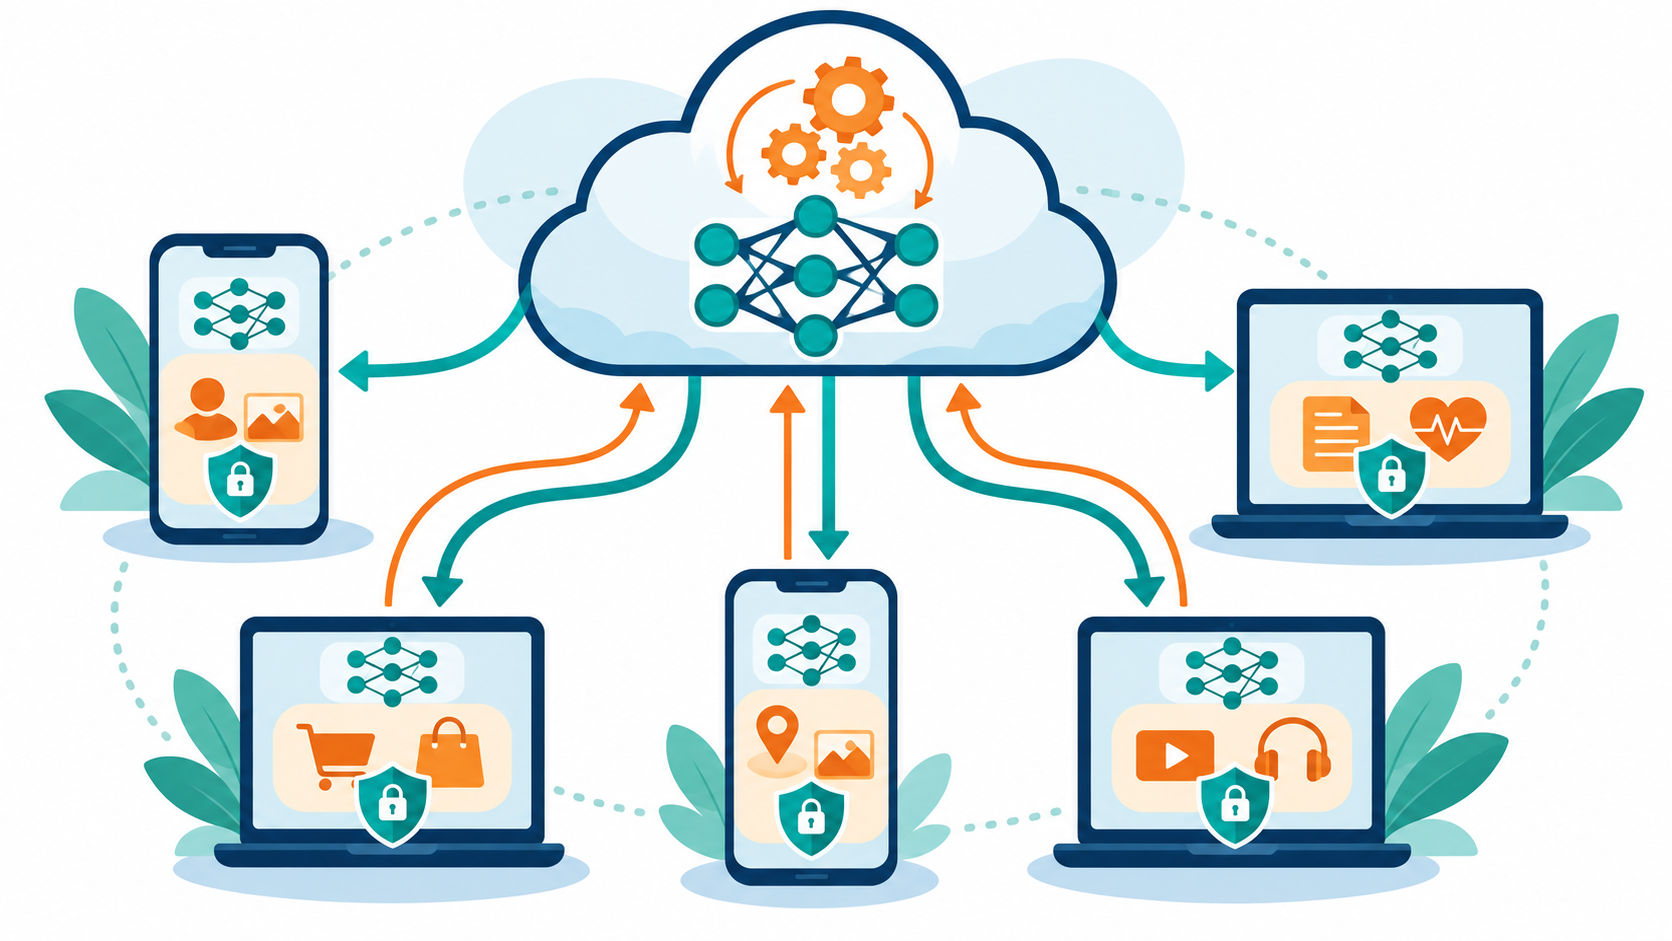
Merkezî eğitimde örnekler sunucuya taşınır ve model orada eğitilir. Federated learning akışında ise eğitim işi katılımcılara dağıtılır:
- Sunucu başlangıç modelini seçilen cihazlara veya kurumlara gönderir.
- Her katılımcı modeli kendi yerel verisiyle kısa süre eğitir.
- Katılımcı, ham kayıtları değil model güncellemesini sunucuya iletir.
- Sunucu gelen güncellemeleri birleştirip yeni ortak modeli hazırlar ve turu tekrarlar.
Bu döngü, McMahan ve çalışma arkadaşlarının FedAvg makalesinde anlatılan temel yaklaşımdır. İletişim maliyeti yüksek olduğunda, her cihazda birkaç yerel eğitim adımı atıp daha seyrek güncelleme göndermek yararlı olabilir.
FedAvg: güncellemeleri ağırlıklı biçimde birleştirmek
Federated Averaging, kısaca FedAvg, katılımcılardan gelen model ağırlıklarını veya güncellemeleri birleştirir. Verisi daha çok olan katılımcının katkısı genellikle daha fazla ağırlık alır. Sunucu bu ortalamayı yeni model sürümü olarak dağıtır. TensorFlow Federated öğreticisi, sunucudan istemcilere yayın, istemcide yerel güncelleme, güncellemelerin geri alınması ve sunucu modelinin yenilenmesi adımlarını örnek kodla gösterir.
Basit bir örnek: cihaz klavyesi
Bir klavye uygulamasının sıradaki sözcük tahminini geliştirmek istediğini düşünelim. Her kişinin yazdıklarını tek tek merkezî sunucuya yüklemek yerine, model telefona gönderilebilir; eğitim telefondaki örneklerle yapılır ve ortak modele katkı sağlayacak güncelleme geri gönderilir. Bu yalnızca açıklayıcı bir senaryodur: gerçek bir sistemde kullanıcı seçimi, veri saklama kuralları, cihaz koşulları ve güncellemenin nasıl korunduğu ayrıca tasarlanmalıdır.
Ne sağlar, hangi sorunları getirir?
Ham veriyi merkezde toplama ihtiyacını azaltabilir ve daha önce merkezi bir veri havuzuna aktarılamayan dağıtık veriden yararlanmayı mümkün kılabilir. Öte yandan katılımcıların verisi farklı dağılımlara sahip olabilir: bir telefonda kullanılan sözcükler diğerinden, bir klinikteki örnekler başka bir klinikten farklıdır. Bu non-IID yapı, ortak modelin bazı gruplarda daha kötü çalışmasına yol açabilir. Cihazların çevrimdışı kalması, pil ve işlem gücü sınırları ile büyük güncellemelerin ağ maliyeti de hesaba katılmalıdır.
Yerel eğitim neden tek başına gizlilik değildir?
Ham örneklerin gönderilmemesi önemli bir veri minimizasyonu adımıdır; fakat model güncellemeleri de bilgi sızdırabilir veya üyelik çıkarımı gibi saldırılara konu olabilir. Secure Aggregation araştırması, sunucunun tek tek katılımcı katkılarını görmeden yeterli sayıda cihazın toplam güncellemesini elde etmesini sağlayan bir yaklaşımı açıklar. Diferansiyel gizlilik ise uygun gürültü ve bütçe hesabıyla ek bir gizlilik sınırı sunabilir; bunun model kalitesi üzerinde maliyeti olabilir. Hangi korumanın gerektiği tehdit modeline bağlıdır.
Küçük bir federated learning denemesi için adımlar
- Katılımcıyı tanımlayın: telefon, kurum veya sunucu düğümü mü? Her katılımcının hangi veriye erişeceğini yazılı hale getirin.
- Önce simülasyon kurun: farklı boyut ve dağılımlardaki istemcilerle FedAvg akışını sınayın. Ortalama başarıya ek olarak her grup için ölçüm alın.
- Bağlantı ve katılımı modelleyin: çevrimdışı kalan cihazları, örnekleme oranını ve güncelleme boyutunu test edin.
- Gizlilik incelemesi yapın: güncellemelerin kimlerce görüldüğünü ve sunucunun ne öğrenebileceğini değerlendirin; gerekiyorsa secure aggregation ve diferansiyel gizliliği ekleyin.
- Yayın öncesi izleyin: modelin kalite, gecikme ve gruplar arası performansını takip edin; kullanıcı kontrolü ve veri silme sürecini belirleyin.
Özetle federated learning, veriyi yerinde tutarak ortak öğrenmeyi mümkün kılan bir eğitim düzenidir. Başarılı uygulama için FedAvg algoritması kadar katılımcı çeşitliliği, ağ koşulları ve açık bir gizlilik tasarımı da önemlidir.